BnF chantier traces

Projet Matérialités du JV. Constituer le corpus à partir du catalogue de la BnF

Le premier billet concernant le projet « Matérialités du jeu vidéo » présentait un tri des 30 674 jeux vidéo que recense le catalogue général de la BnF, d’après la description matérielle de leurs notices. Ce corpus n’existe pas tel quel dans le catalogue : il a fallu le constituer, notice par notice. Ce second billet en détaille la méthode, pour qu’elle puisse être discutée, reprise ou appliquée à d’autres fonds. Il expose l’interrogation du catalogue, les cinq requêtes de la moisson et leurs mots, leur découpage, la reconnaissance des jeux parmi les notices et la logique des cotes de rangement.

Interroger le catalogue

Le catalogue général de la BnF s’interroge par une interface de programmation (API) au protocole SRU, pour Search/Retrieve via URL, documentée sur le portail BnF API et jeux de données. Chaque requête prend la forme d’une adresse web, qui précise l’opération demandée, la requête elle-même, le format des notices et le nombre de notices voulues :

https://catalogue.bnf.fr/api/SRU?version=1.2&operation=searchRetrieve
  &query=bib.doctype any "s r" and bib.anywhere any "jeu jeux"
  &recordSchema=unimarcXchange
  &maximumRecords=1000&startRecord=1

Dans l’adresse réelle, les quatre lignes n’en font qu’une, et les espaces comme les guillemets sont encodés. La requête s’écrit dans le langage CQL (Contextual Query Language), normalisé par la Bibliothèque du Congrès. Chaque clause y associe un index, une relation et un ou plusieurs mots. Ainsi, bib.anywhere any "jeu jeux" cherche dans tous les champs de la notice l’un ou l’autre des deux mots ; la relation all exigerait les deux, la relation adj l’expression exacte. Les opérateurs and, or et not combinent les clauses. La recherche ignore les accents : « ludo-educatif » et « ludo-éducatif » ramènent le même nombre de notices.

La moisson emploie cinq index :

  • bib.doctype, le type de document, codé par une lettre : s pour les documents électroniques, r pour les documents multimédias multisupports, p pour les objets ;
  • bib.anywhere, l’ensemble des mots de la notice ;
  • bib.cote, les mots de la cote ;
  • bib.subject, les sujets et les genres attribués par la BnF ;
  • bib.creationdate, la date de création de la notice.

Parmi les formats de notice proposés, seul l’UNIMARC (unimarcXchange) livre les données d’exemplaire, c’est-à-dire la cote et la localisation de chaque objet, sans lesquelles aucune demande de communication n’est possible.

Cinq requêtes complémentaires

Le mot « jeu » ne suffit pas à repérer les jeux vidéo, et il en ramène trop. Une partie des notices de jeux n’en contient aucune occurrence : notices minimales réduites au titre, à la plateforme et à la cote, éditions collector cataloguées comme objets. À l’inverse, le mot figure dans bien des notices de logiciels éducatifs ou de documentaires. J’ai donc combiné cinq requêtes, dont trois écartent, par une clause not, les notices déjà ramenées par la première.

La première porte sur les documents électroniques et multimédias qui contiennent « jeu » ou « jeux » dans un champ quelconque. Elle ramène 38 123 notices, d’où proviennent 30 001 des 30 674 jeux finalement retenus.

bib.doctype any "s r" and bib.anywhere any "jeu jeux"

La deuxième cherche, dans les mêmes types de documents, 42 noms de plateformes et de supports, qui se rangent en six familles.

Famille Mots
Constructeurs nintendo, sega, atari, commodore
Consoles de salon playstation, ps2, ps3, ps4, ps5, xbox, wii, switch, gamecube, nes, snes, megadrive, saturn, dreamcast, neogeo, 3do, jaguar
Consoles portables gameboy, psp, vita, lynx
Ordinateurs amiga, amstrad, spectrum, msx, oric
Supports et accessoires console, consoles, cartouche, cartouches, manette
Codes des notices récentes proprietaire, eps2, eps3, eps4, eps5, eswi, eumd

La liste reprend les noms sous lesquels les notices désignent les plateformes, dans le titre uniforme (« Atari ST ») ou dans la description du support (« 1 cartouche Super Nintendo »). La dernière famille provient des notices créées depuis 2025, qui décrivent par exemple un « Blu-ray Disc propriétaire eps5 ». Les codes eps2 à eps5 y désignent les PlayStation, eswi la Switch, eumd les disques UMD de la PSP. L’index compare des mots entiers. Dans l’ensemble du catalogue, gameboy ne trouve que 46 notices, quand l’expression « game boy » en compte 933 ; les noms de constructeurs, comme nintendo, rattrapent ces graphies. Le PC, le Mac et Windows sont absents à dessein : ces mots figurent dans presque toutes les notices de logiciels, utilitaires compris, et auraient noyé la moisson.

bib.doctype any "s r"
and bib.anywhere any "playstation xbox nintendo switch wii gamecube gameboy snes nes megadrive saturn dreamcast sega atari amiga amstrad commodore spectrum msx oric neogeo 3do jaguar lynx console consoles cartouche cartouches manette proprietaire eps2 eps3 eps4 eps5 eswi eumd psp vita ps2 ps3 ps4 ps5"
not bib.anywhere any "jeu jeux"

Le rendement de ces mots est très inégal, car la plupart des notices qui les contiennent mentionnent aussi « jeu » et figurent déjà dans la première requête. La deuxième ramène 3 656 notices, dont 448 jeux ; 46 seulement n’ont été atteints par aucune autre requête. Pour 39 d’entre eux, trois mots ont joué, souvent ensemble : cartouche (38 jeux), console (37) et nintendo (36). Il s’agit pour l’essentiel de notices minimales de jeux pour Nintendo DS et 3DS (36), qui ne disent pas « jeu ». Plusieurs noms ne ramènent aucune notice, comme gamecube, megadrive, neogeo ou les codes eps3 à eumd.

D’autres ramènent surtout du bruit, d’autant que le type « document électronique » couvre aussi les livres numériques et les revues en ligne. L’index ignorant les accents, nes rencontre le participe « nés » des ouvrages de néonatologie : 316 notices, pour un seul jeu. Le mot spectrum en ramène 1 645, sur le spectre autistique ou les fréquences radio, pour un seul jeu également ; vita (191 notices), proprietaire (94) et jaguar (82) n’en apportent aucun. La reconnaissance des jeux, notice par notice, écarte ces faux rapprochements.

La troisième part des cotes, qui désignent l’emplacement des exemplaires en magasin. En examinant les cotes des jeux que ramenait la première requête, j’ai relevé six séries qui en réunissent la plupart : MDC 12, MDVD, MY, MZ, VDC 12 et VY (voir la section « Ce que disent les cotes »). La requête retient tout ce qui est coté dans ces séries, sauf les notices déjà ramenées et celles auxquelles la BnF attribue le genre « non fiction », logiciels utilitaires ou bases de données. Elle ramène 18 686 notices, surtout des logiciels étrangers au jeu, mais aussi 606 jeux, dont 203 qu’aucune autre requête n’atteint.

bib.cote any "MDC MDVD MZ MY VDC VY"
not bib.anywhere any "jeu jeux"
not bib.subject all "non fiction"

La quatrième vise les objets, type de document sous lequel sont parfois catalogués des éditions collector, des figurines ou des accessoires. Elle ramène 200 notices, dont 19 jeux, tous déjà présents dans la première.

bib.doctype any "p"
and bib.anywhere any "jeu jeux console consoles manette nintendo playstation xbox sega atari amiibo figurine"

La cinquième rattrape enfin les logiciels ludo-éducatifs dont la notice ne dit pas « jeu » : 839 notices, dont 25 jeux.

bib.doctype any "s r"
and bib.anywhere any "ludo-educatif ludoeducatif ludoeducatifs"
not bib.anywhere any "jeu jeux"

Ensemble, les cinq requêtes réunissent 61 504 notices, ramenées à 60 257 une fois les doublons retirés. Les quatre requêtes complémentaires apportent 673 jeux, soit 2 % du total, tous absents de la première.

Découper pour tout recevoir

Le service plafonne chaque réponse à 1 000 notices. Plutôt que de paginer des dizaines de milliers de résultats dans un catalogue qui évolue pendant la moisson, j’ai découpé chaque requête selon la date de création des notices (index bib.creationdate, relation within) :

(bib.doctype any "s r" and bib.anywhere any "jeu jeux")
and bib.creationdate within "19980102 19990101"

Une tranche qui dépasse 1 000 notices est coupée en deux, puis de nouveau en deux, jusqu’à tenir dans une réponse ; seule une journée trop chargée, lors d’un chargement massif, est encore paginée. Chaque tranche est contrôlée contre l’effectif annoncé par le service, que l’on obtient en demandant zéro notice. Les cinq lots ont été reçus en entier, en moins d’une heure, au rythme d’une requête par seconde au plus. Une moisson interrompue reprend où elle s’était arrêtée.

Reconnaître les jeux vidéo

Une notice UNIMARC se compose de zones numérotées, divisées en sous-zones. Celle d’Ultima V, dans sa version pour Atari ST datée de 1989, en donne un exemple (extrait ; notice complète) :

135    $a gjca|||||||||
200 1  $a Ultima $h V $i Warriors of destiny $b Ressource électronique $f Origin Systems $g by Lord British
210    $a Londonderry (NH) $c Origin Systems $d cop. 1989
215    $a 3 disquette (3,5 pouces) $c coul., son. $d 9 cm $e 1 manuel d'utilisateur (70 p.) $e 1 manuel d'information (54 p.) $e 2 dépl. $e 2 f. $e 1 jeton $e 1 carte en tissu coton
230    $a Jeu multimédia
500 11 $a Ultima $h V $i Warriors of destiny $n jeu vidéo $m anglais $q Atari ST
608    $a jeu de rôle, d'aventure, de plate-forme $2 frTAV
608    $a jeu vidéo $2 frTAV
930    $a MZ-3772 $c Tolbiac - Rez de Jardin - Audiovisuel - Magasin

Plusieurs zones désignent ici un jeu vidéo. Le code g, en tête de la zone 135, signale un jeu parmi les ressources électroniques. Le titre uniforme (zone 500) est qualifié de « jeu vidéo » et nomme la plateforme. La zone 608 porte le genre « jeu vidéo » attribué par la BnF. Deux autres zones intéressent directement le projet : la zone 215 décrit le contenu de la boîte, la zone 930 l’exemplaire, avec sa cote, MZ-3772, et sa localisation en magasin.

Le classement des notices exploite ces zones selon une hiérarchie explicite. Comptent comme critères décisifs le genre « jeu vidéo », le titre uniforme qualifié de « jeu vidéo », le code g de la zone 135, une console comme plateforme ou un support en cartouche. Les genres de jeu (« jeu de rôle », « jeu d’action »…), le type de ressource « jeu multimédia » (zone 230) ou une note propre aux jeux pèsent moins. Un sujet « jeux vidéo » de l’indexation RAMEAU pèse moins encore.

Une notice qui réunit au moins un critère décisif est retenue avec certitude ; une notice qui n’a que des critères secondaires est jugée probable. Chaque notice conserve la liste des critères qui l’ont fait retenir, de sorte que le classement peut être repris à la main. Les notices minimales, sans genre ni type de ressource, posent le problème le plus délicat. Pour les ordinateurs anciens et les consoles, presque tout ce qui a été déposé est du jeu, et la notice est retenue comme probable. Pour le PC et le Mac, les logiciels utilitaires sont trop nombreux : la notice reste un cas limite, sauf si son titre est celui d’un jeu attesté ailleurs dans le corpus.

Il en ressort 30 674 jeux vidéo, dont 28 367 retenus avec certitude et 2 307 jugés probables. Les 4 104 cas limites sont tenus à part, notamment 1 539 numéros de revues accompagnés d’un disque de démonstrations et 686 notices minimales sans genre ni plateforme. Les 25 479 notices écartées sont pour l’essentiel des logiciels étrangers au jeu, des documents sans support informatique, des revues et des documents numérisés. Les logiciels ludo-éducatifs, les jeux diffusés en kiosque comme numéros de revue et les jeux déposés sous forme de fichiers restent dans le corpus. Les numéros de magazines accompagnés d’un disque demeurent des cas limites.

Ce que disent les cotes

La cote d’Ultima V, MZ-3772, associe un préfixe de série et un numéro. Je n’ai trouvé aucun document de la BnF qui explicite les lettres de ces préfixes ; leur logique se lit toutefois dans les données. Les six séries de la troisième requête se répartissent ainsi.

Série Supports Plateformes les plus représentées Jeux Années des jeux (médiane) Notices créées
MZ disquettes, cassettes Amiga, Atari ST, Amstrad CPC 1 906 1980-2002 (1990) 1996-2026
VY cartouches Game Boy, Super Nintendo, Nintendo 64 320 1985-1999 (1994) 1995-2001
MY cartouches, cartes de jeu Nintendo DS, Switch, Game Boy Advance 4 234 1978-2026 (2006) 2000-2026
VDC 12 cédéroms PC, PlayStation, CD-i, Saturn 1 076 1990-2001 (1997) 1995-2025
MDVD DVD, mini-DVD, UMD PlayStation 2, PC, Xbox, GameCube 3 357 1998-2008 (2005) 1999-2009
MDC 12 cédéroms, DVD, Blu-ray PC, PlayStation 3 et 4, Xbox 360 11 785 1989-2026 (2007) 1996-2026

Le préfixe désigne une famille de supports : disquettes et cassettes en MZ, cartouches en VY puis en MY, disques optiques en VDC 12, MDVD et MDC 12. Le nombre 12 renvoie vraisemblablement au diamètre des disques, en centimètres. Le numéro suit l’ordre d’entrée. Dans MDC 12, MDVD et MY, il croît avec la date de création de la notice de façon presque parfaite (corrélation de rang comprise entre 0,98 et 1). Le rangement obéit ainsi au principe du numerus currens, ordinaire dans les magasins de bibliothèque : par format, dans l’ordre d’arrivée.

L’époque qui distingue les séries est donc celle du catalogage. VY réunit des cartouches cataloguées de 1995 à 2001, MDVD des jeux sur DVD catalogués de 1999 à 2009, tandis que MY et MDC 12 restent ouvertes. Une cartouche de Mega Drive de 1993 peut dès lors porter une cote MY : les 336 jeux de cette console cotés dans la série ont été catalogués, en médiane, en 2009.

Ces séries sont-elles celles du jeu ? Le corpus final le confirme dans les deux sens. D’un côté, 93,8 % des jeux sur support physique y sont cotés. Les autres relèvent des revues (PER MDC, PER MU) et des multisupports (8 MU, FOL MU). Quelques-uns appartiennent aux collections de la salle A, en libre accès (SW, JV, PS, XB), à celles du Centre national de la littérature pour la jeunesse (CNLJM) ou à des séries particulières. De l’autre, les jeux dominent parmi les notices moissonnées de chaque série : la totalité en VY, 96 % en MY, 89 % en MDVD, 81 % en VDC 12. MDC 12 et MZ sont plus mêlées ; la première accueille aussi des logiciels éducatifs et utilitaires (59 % de jeux), la seconde des documents sans support informatique (26 % de jeux).

Pour qui prépare une visite des magasins, la cote renseigne sur le support et sur la date d’entrée. Celle-ci suit de près la parution pour les jeux récents, beaucoup moins pour les jeux anciens entrés plus tard. Le sens des lettres reste à confirmer auprès des conservateurs et conservatrices du fonds.

Limites de la méthode

La moisson décrit le catalogue tel qu’il était le 10 octobre 2026. En juin 2026, la BnF a changé d’outil, de format et de modèle de catalogage, avec l’ouverture de Noemi, et ce changement affecte les données consultées ou récupérées (centre d’aide de la BnF). Une moisson ultérieure devra vérifier que les mêmes requêtes ramènent toujours les mêmes ensembles.

Les mots retenus restent par ailleurs révisables : leur rendement, mesuré mot par mot, indique ceux qu’il faudrait ajouter ou retirer. Le classement, enfin, produit des certitudes graduées. Les 2 307 jeux probables et les 4 104 cas limites demandent un contrôle à la main, que la liste des critères conservée pour chaque notice permet de conduire.

Sources et documentation

Données : catalogue général de la BnF, interrogé par son API SRU le 10 octobre 2026 ; métadonnées diffusées sous Licence Ouverte (Etalab). Traitements : Björn-Olav Dozo.
BnF chantier traces

Matérialités du jeu vidéo. Projet de chercheur associé à la Bibliothèque nationale de France

Le projet Matérialités du jeu vidéo a été retenu par la BnF. J’ai commencé à y travailler à distance. La première chose était de récupérer la liste des jeux vidéo catalogué par la BnF, via l’API SRU du catalogue général (format UNIMARC, avec cotes et localisations). Voici le détail avec Claude.

Le projet, accueilli au département Son, vidéo, multimédia, porte sur les boîtes de jeux vidéo que la BnF conserve, pour l’essentiel au titre du dépôt légal. Boîtiers, modes d’emploi, cartes du monde, figurines, accessoires, dispositifs de protection contre la copie et supports du logiciel y occupent des centaines de mètres linéaires. La conservation du jeu vidéo s’attache pourtant d’abord au code, qu’il s’agit de continuer à exécuter, sur la plateforme d’origine ou par émulation.

Le projet vise à établir un protocole de description de ces emballages, sous la forme d’une grille qui permette de les comparer par plateforme et dans le temps, et à l’éprouver sur la collection elle-même. Ce carnet en suivra l’avancement. Avant l’examen des objets, le catalogue offre déjà une prise sur le fonds : ce premier billet présente ce qu’il dit des boîtes et un premier tri des jeux, que résument trois graphiques. La constitution du corpus fait l’objet d’un billet méthodologique distinct, « Repérer les jeux vidéo dans le catalogue de la BnF : requêtes, notices et cotes ». La préparation des séances de consultation et la grille descriptive viendront dans un billet ultérieur.

Un corpus tiré du catalogue

Le corpus provient du catalogue général de la BnF, interrogé par son interface de programmation (API) au protocole SRU. Cinq requêtes complémentaires l’ont constitué. La première porte sur les documents électroniques et multimédias qui contiennent « jeu » ou « jeux ». Les quatre autres rattrapent les notices qui ne le disent pas : elles cherchent des noms de plateformes, les séries de cotes du département, les objets et les logiciels ludo-éducatifs. Elles réunissent 60 257 notices distinctes, que des règles explicites départagent ensuite : genre attribué par la BnF, plateforme, type de support.

Il en ressort 30 674 jeux vidéo, dont 28 367 identifiés avec certitude et 2 307 jugés probables ; 4 104 cas limites sont tenus à part. Les logiciels ludo-éducatifs, les jeux diffusés en kiosque comme numéros de revue et les jeux déposés sous forme de fichiers restent dans le corpus. Le PC représente près de la moitié des jeux (14 851). La BnF annonce « plus de 22 000 titres » pour sa collection de jeux vidéo (présentation de la collection), chiffre qui correspond, à peu de chose près, aux jeux sur support physique identifiés avec certitude (21 870).

Ce que les notices disent des boîtes

La notice d’Ultima V, dans sa version pour Atari ST datée de 1989, décrit ainsi l’exemplaire conservé : trois disquettes, deux manuels de 70 et 54 pages, deux dépliants, deux feuillets, un jeton et une carte en tissu de coton (notice complète). La zone de description matérielle de la notice recense le support, le nombre d’unités, parfois les dimensions, et ce que le catalogue appelle le « matériel d’accompagnement ». Les notes la complètent par une mention d’âge portée par le conteneur, par l’indication d’une édition spéciale ou, pour certains jeux récents, par cette précision : « Le conteneur ne renferme pas de support ».

Dans ces descriptions et ces notes, j’ai relevé une vingtaine de familles d’indices matériels, des affiches aux figurines, des bandes originales aux dispositifs de protection contre la copie. Au total, 3 294 jeux présentent au moins un indice distinctif, et 543 en cumulent trois ou plus.

Ces informations restent inégales. Leur précision varie en effet selon les époques de catalogage et selon les supports. Surtout, le catalogue ne mesure pas les boîtes : les grandes boîtes cartonnées des jeux pour ordinateur des années 1980 et 1990 y sont invisibles.

Un premier tri d’après le catalogue

La grille descriptive que je prépare comporte un champ de synthèse, le type matériel, qui range chaque exemplaire dans l’une de huit classes. Ce sont la boîte ordinaire, la boîte enrichie, la grande boîte, l’édition collector, le jeu à objet indispensable, l’emballage économique ou de presse, la compilation et la boîte sans support. Les notices permettent d’en proposer une estimation pour l’ensemble du corpus, avant tout examen.

Les règles d’estimation exigent une trace matérielle. Une édition dite « collector » ou « deluxe » sans contenant particulier ni objets joints décrits reste ainsi une boîte ordinaire ou enrichie, ce qui concerne 317 jeux. De même, un mot du seul titre, comme dans Gloom Deluxe, ne vaut pas mention d’édition. La grande boîte échappe au tri, puisque le catalogue ne mesure pas les contenants. Une hypothèse tirée de la plateforme et de l’époque en tient lieu, « probable » pour 2 030 jeux et « possible » pour 2 446 : la visite des magasins la vérifiera.

Sur les 30 674 jeux, 6 494 ont été déposés sous forme de fichiers et sortent du tri, faute d’objet ; 44 n’ont aucune description matérielle. Les 24 136 jeux classés se répartissent comme suit.

Type matérielJeuxPart des jeux classés
Boîte ordinaire20 28584,0 %
Boîte enrichie1 4846,1 %
Emballage économique ou de presse1 0364,3 %
Jeu à objet indispensable5392,2 %
Compilation4581,9 %
Édition collector2701,1 %
Boîte sans support640,3 %
Total24 136100 %

Trois lectures du tri

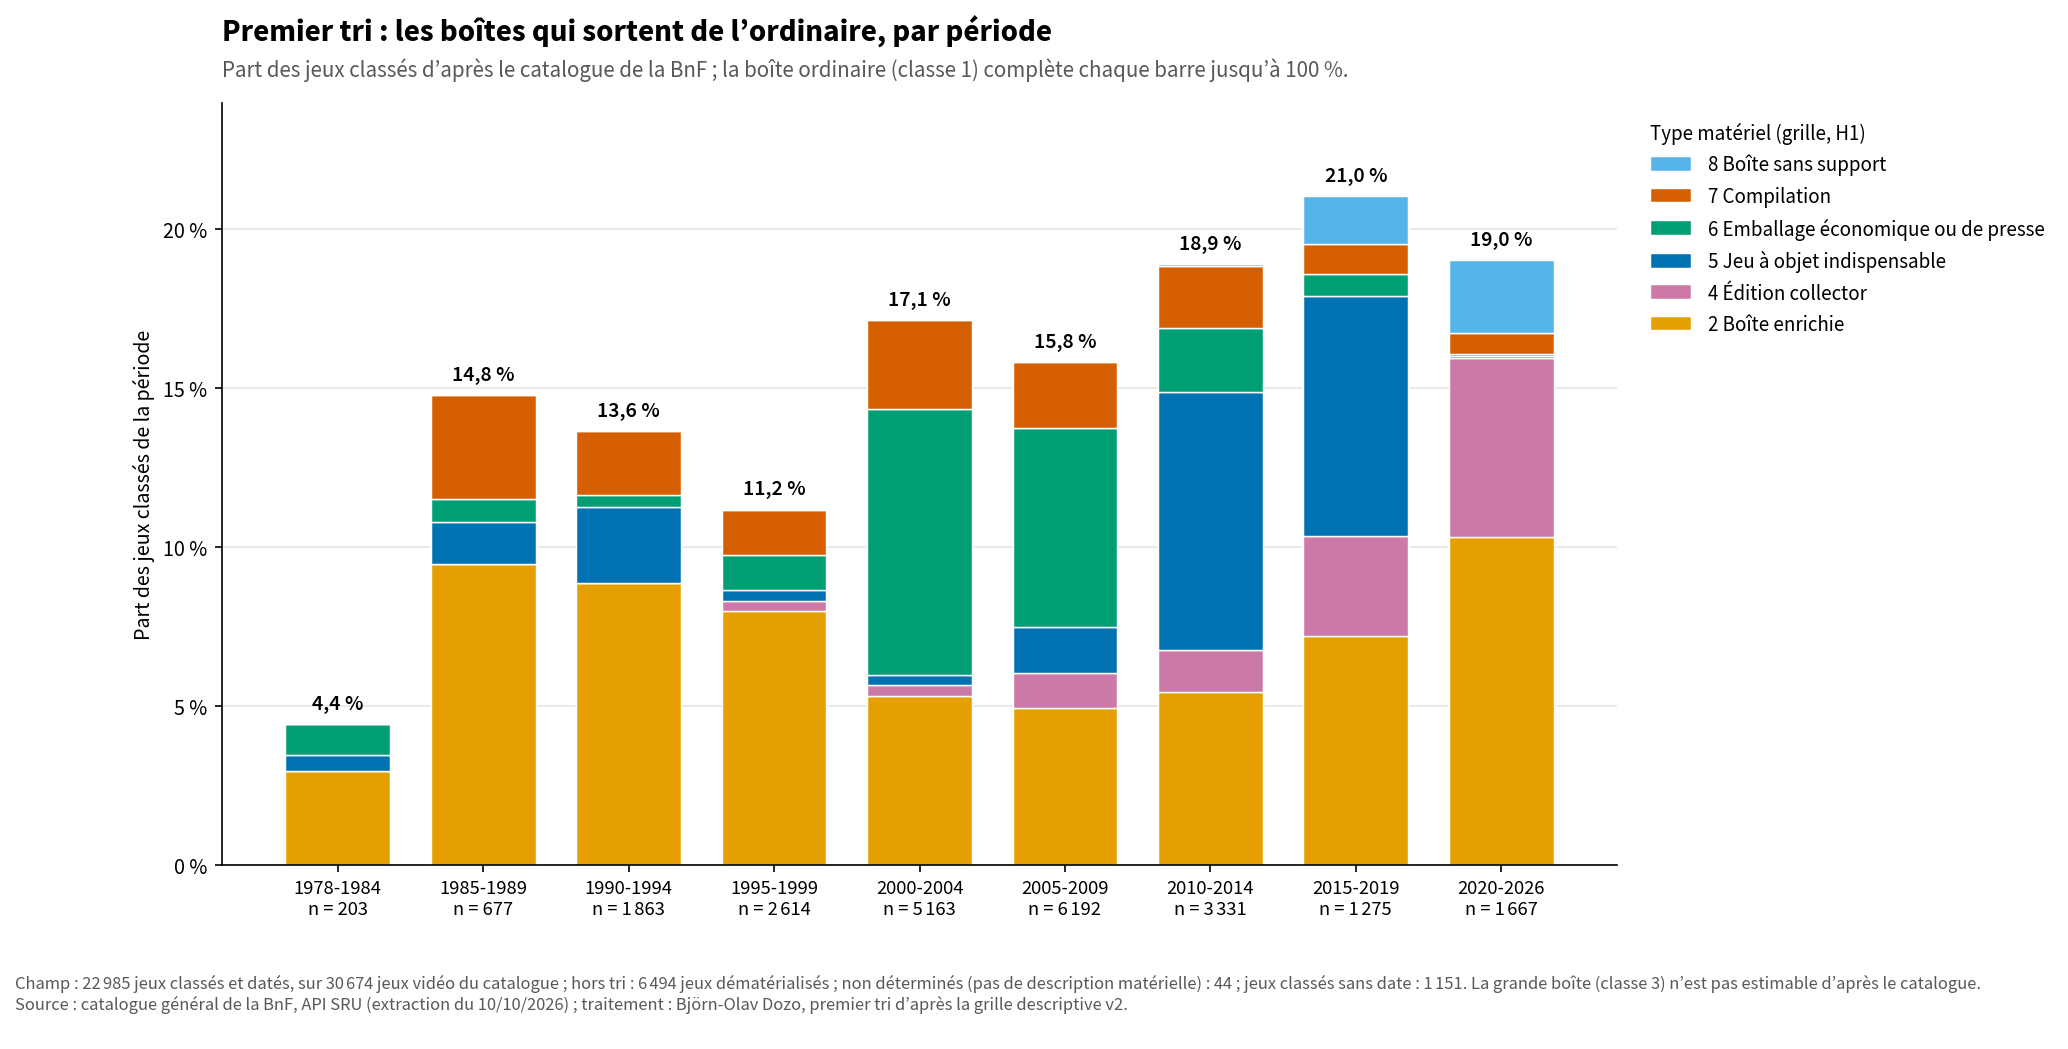
Histogramme empilé par période de cinq ans, de 1978 à 2026. La part des boîtes autres qu’ordinaires vaut 4,4 % en 1978-1984, 14,8 % en 1985-1989, 17,1 % en 2000-2004 et 21,0 % en 2015-2019. Les boîtes enrichies dominent jusqu’en 1999, le kiosque et les petits prix en 2000-2009, les objets indispensables en 2010-2019, les boîtes enrichies et les éditions collector depuis 2020.
Figure 1. Part des types matériels autres que la boîte ordinaire, par période de cinq ans, parmi les jeux classés d’après le catalogue de la BnF.

La part des boîtes qui sortent de l’ordinaire varie de 11 à 21 % selon les périodes de cinq ans, si l’on met à part les premières années, aux effectifs réduits (figure 1). Sa composition change davantage que son niveau. De 1985 à 1999, les boîtes enrichies dominent ; les jeux pour ordinateur en représentent les quatre cinquièmes, alors qu’ils ne forment que six jeux classés sur dix. Les années 2000 sont celles du kiosque et des rééditions à petit prix, qui comptent pour 8,3 % des jeux classés en 2000-2004. Les jeux à objet indispensable l’emportent en 2010-2019. Depuis 2020, les boîtes enrichies reviennent au premier plan, et les éditions collector, qui ne représentaient que 0,3 % des jeux classés en 1995-1999, atteignent 5,6 %.

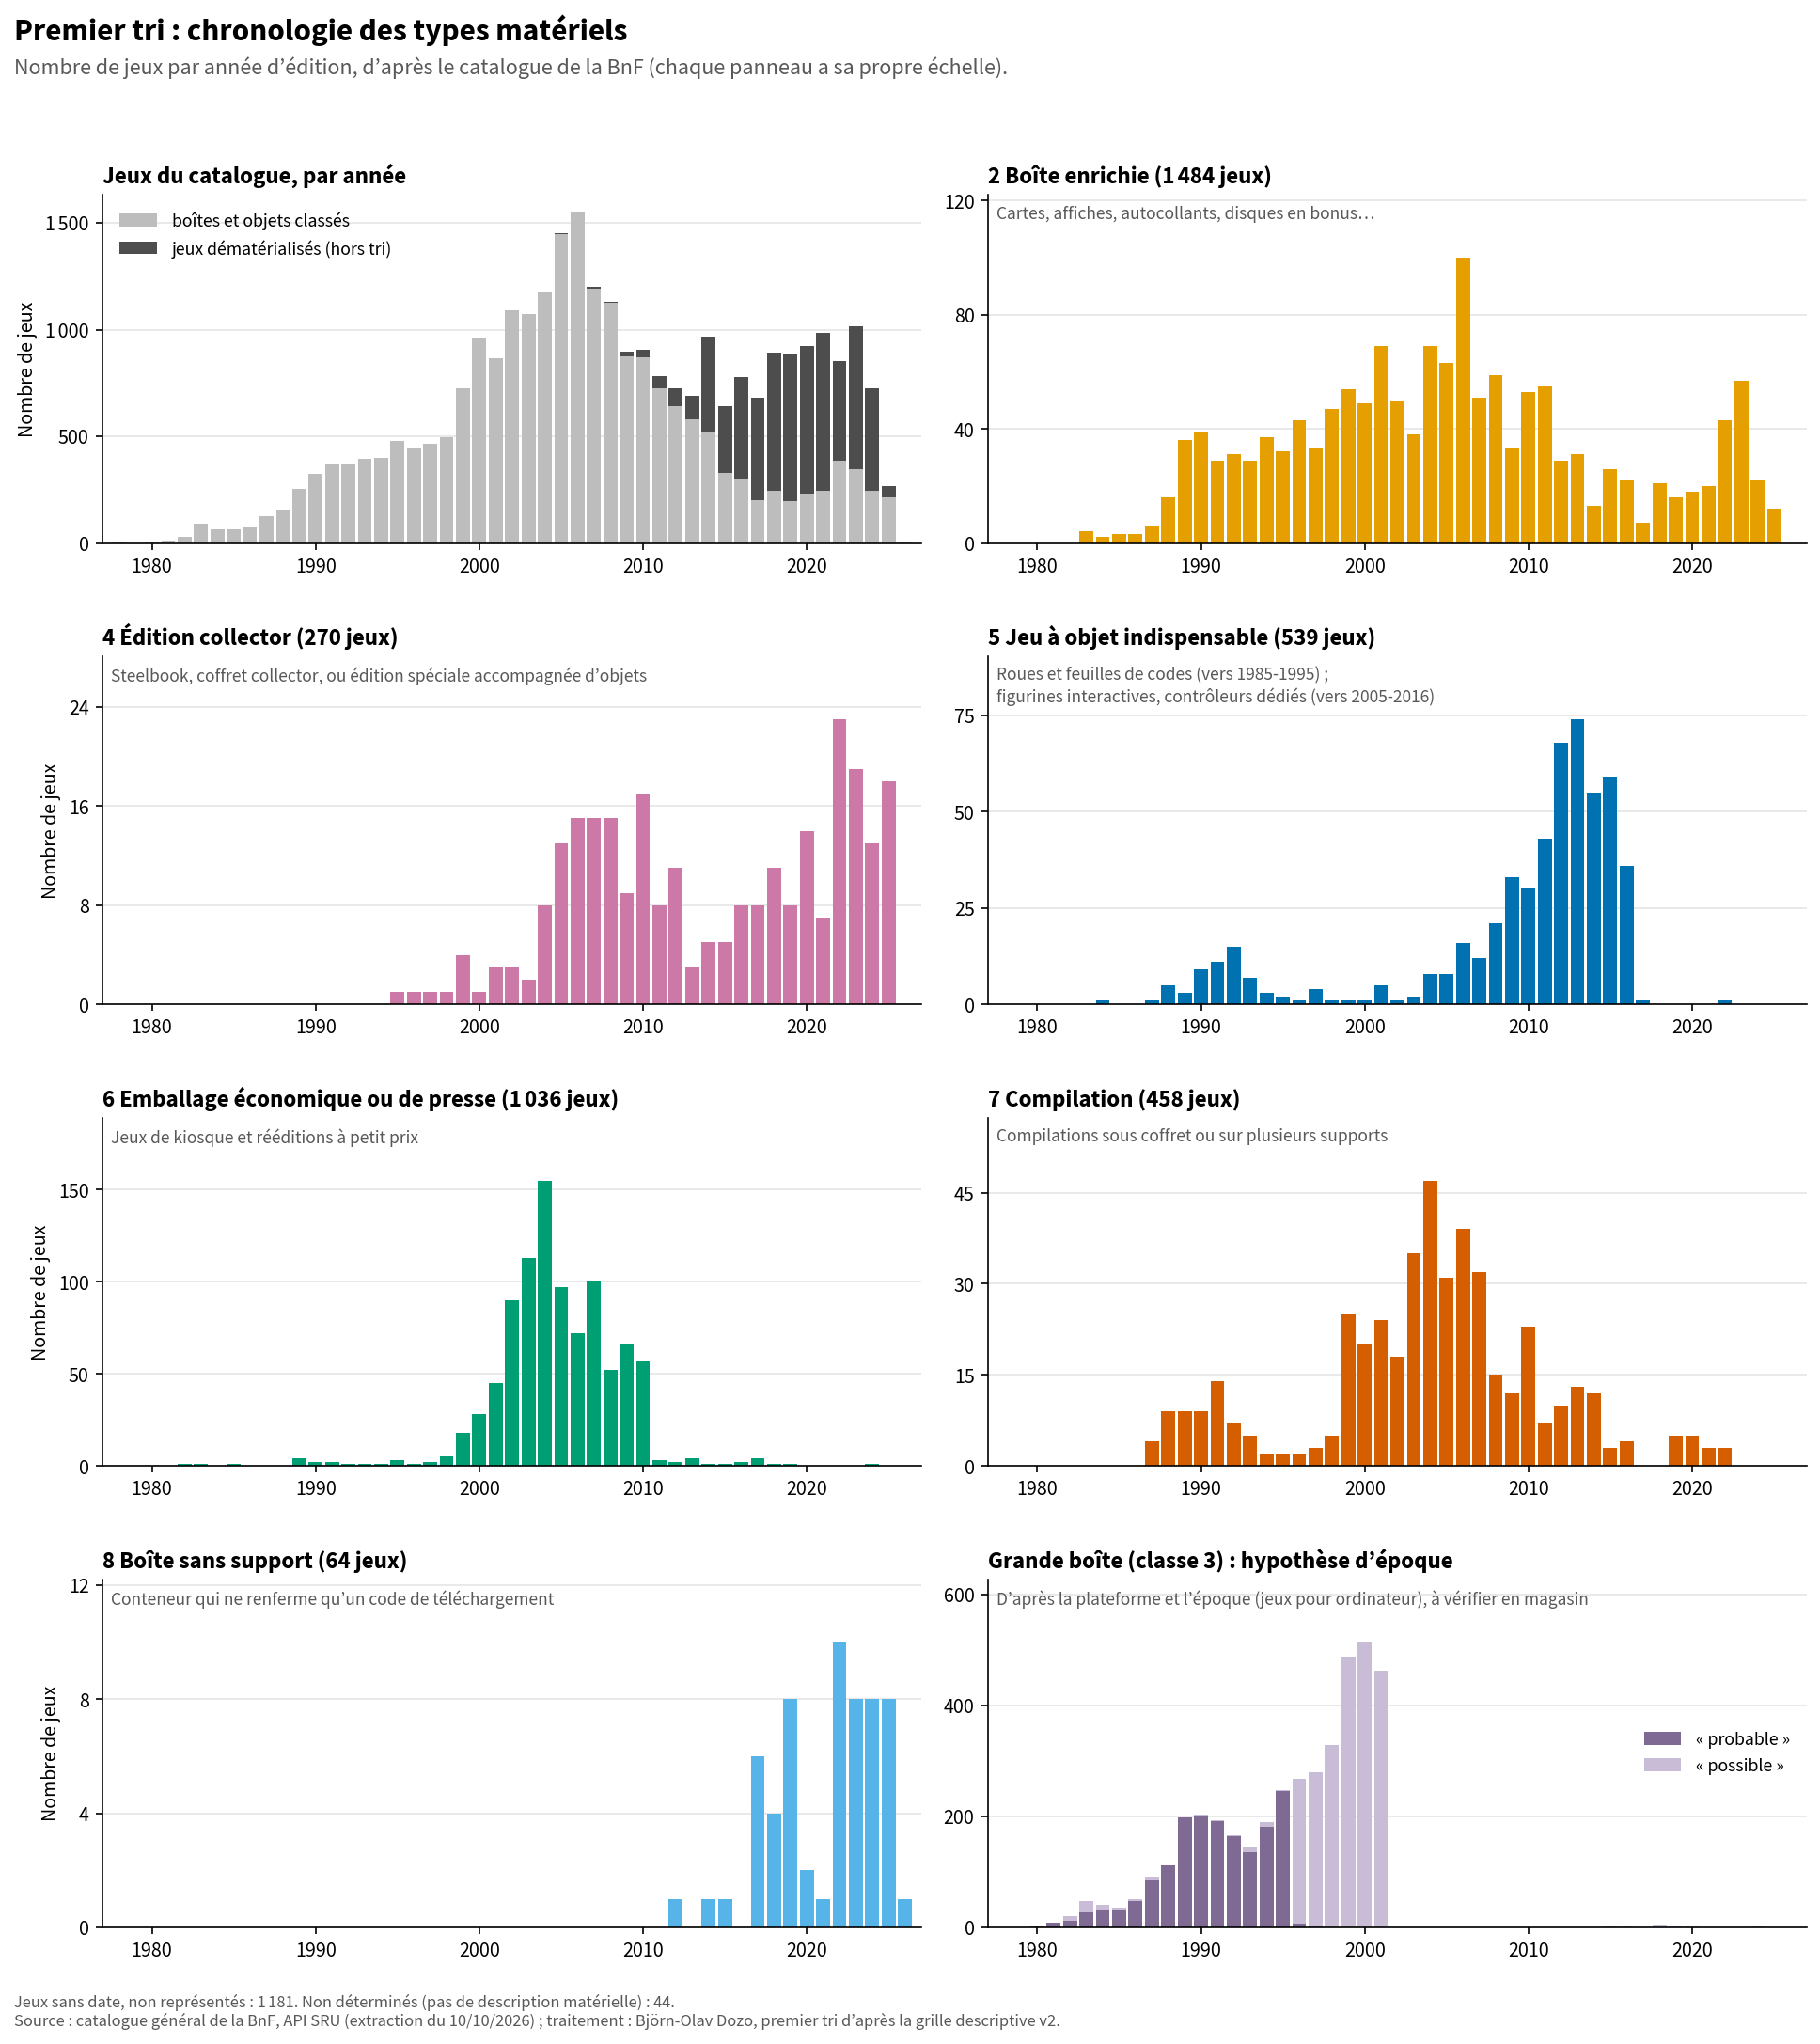
Huit histogrammes annuels, de 1978 à 2026 : jeux du catalogue, les fichiers dépassant les boîtes de 2016 à 2024 ; boîtes enrichies ; éditions collector, en hausse depuis 2005 ; jeux à objet indispensable, avec un premier pic vers 1992 et un sommet en 2013 ; emballages économiques ou de presse, concentrés entre 2000 et 2010 ; compilations ; boîtes sans support, depuis 2017 ; hypothèse de grande boîte, des années 1980 à 2001.
Figure 2. Nombre de jeux par année d’édition et par type matériel. Le premier panneau distingue les boîtes classées et les jeux déposés sous forme de fichiers ; le dernier traduit l’hypothèse de la grande boîte.

Le détail annuel précise ces séquences (figure 2). Les roues et les feuilles de codes, qui protégeaient les jeux contre la copie en exigeant une information imprimée, se concentrent entre la fin des années 1980 et le milieu des années 1990. Les figurines interactives, de Skylanders à Disney Infinity, se diffusent de 2011 à 2016, avec un sommet en 2013 ; 219 notices décrivent une figurine vendue seule, sans support de jeu. L’emballage économique ou de presse culmine en 2004, tandis que les boîtes qui ne renferment qu’un code se multiplient à partir de 2017.

Le premier panneau situe ces évolutions dans celle du dépôt. À partir des jeux de 2014, les fichiers prennent une part importante des entrées ; de 2016 à 2024, ils dépassent chaque année les boîtes, les années les plus récentes restant sans doute incomplètes. La progression des éditions collector s’accorde avec l’hypothèse, formulée dans le projet, d’une portée nouvelle de ces éditions à l’heure de la distribution dématérialisée ; la coïncidence demande encore à être interprétée. Le dernier panneau traduit l’hypothèse de la grande boîte, qui concerne d’abord les jeux pour ordinateur sur disquette, de la fin des années 1980 au milieu des années 1990.

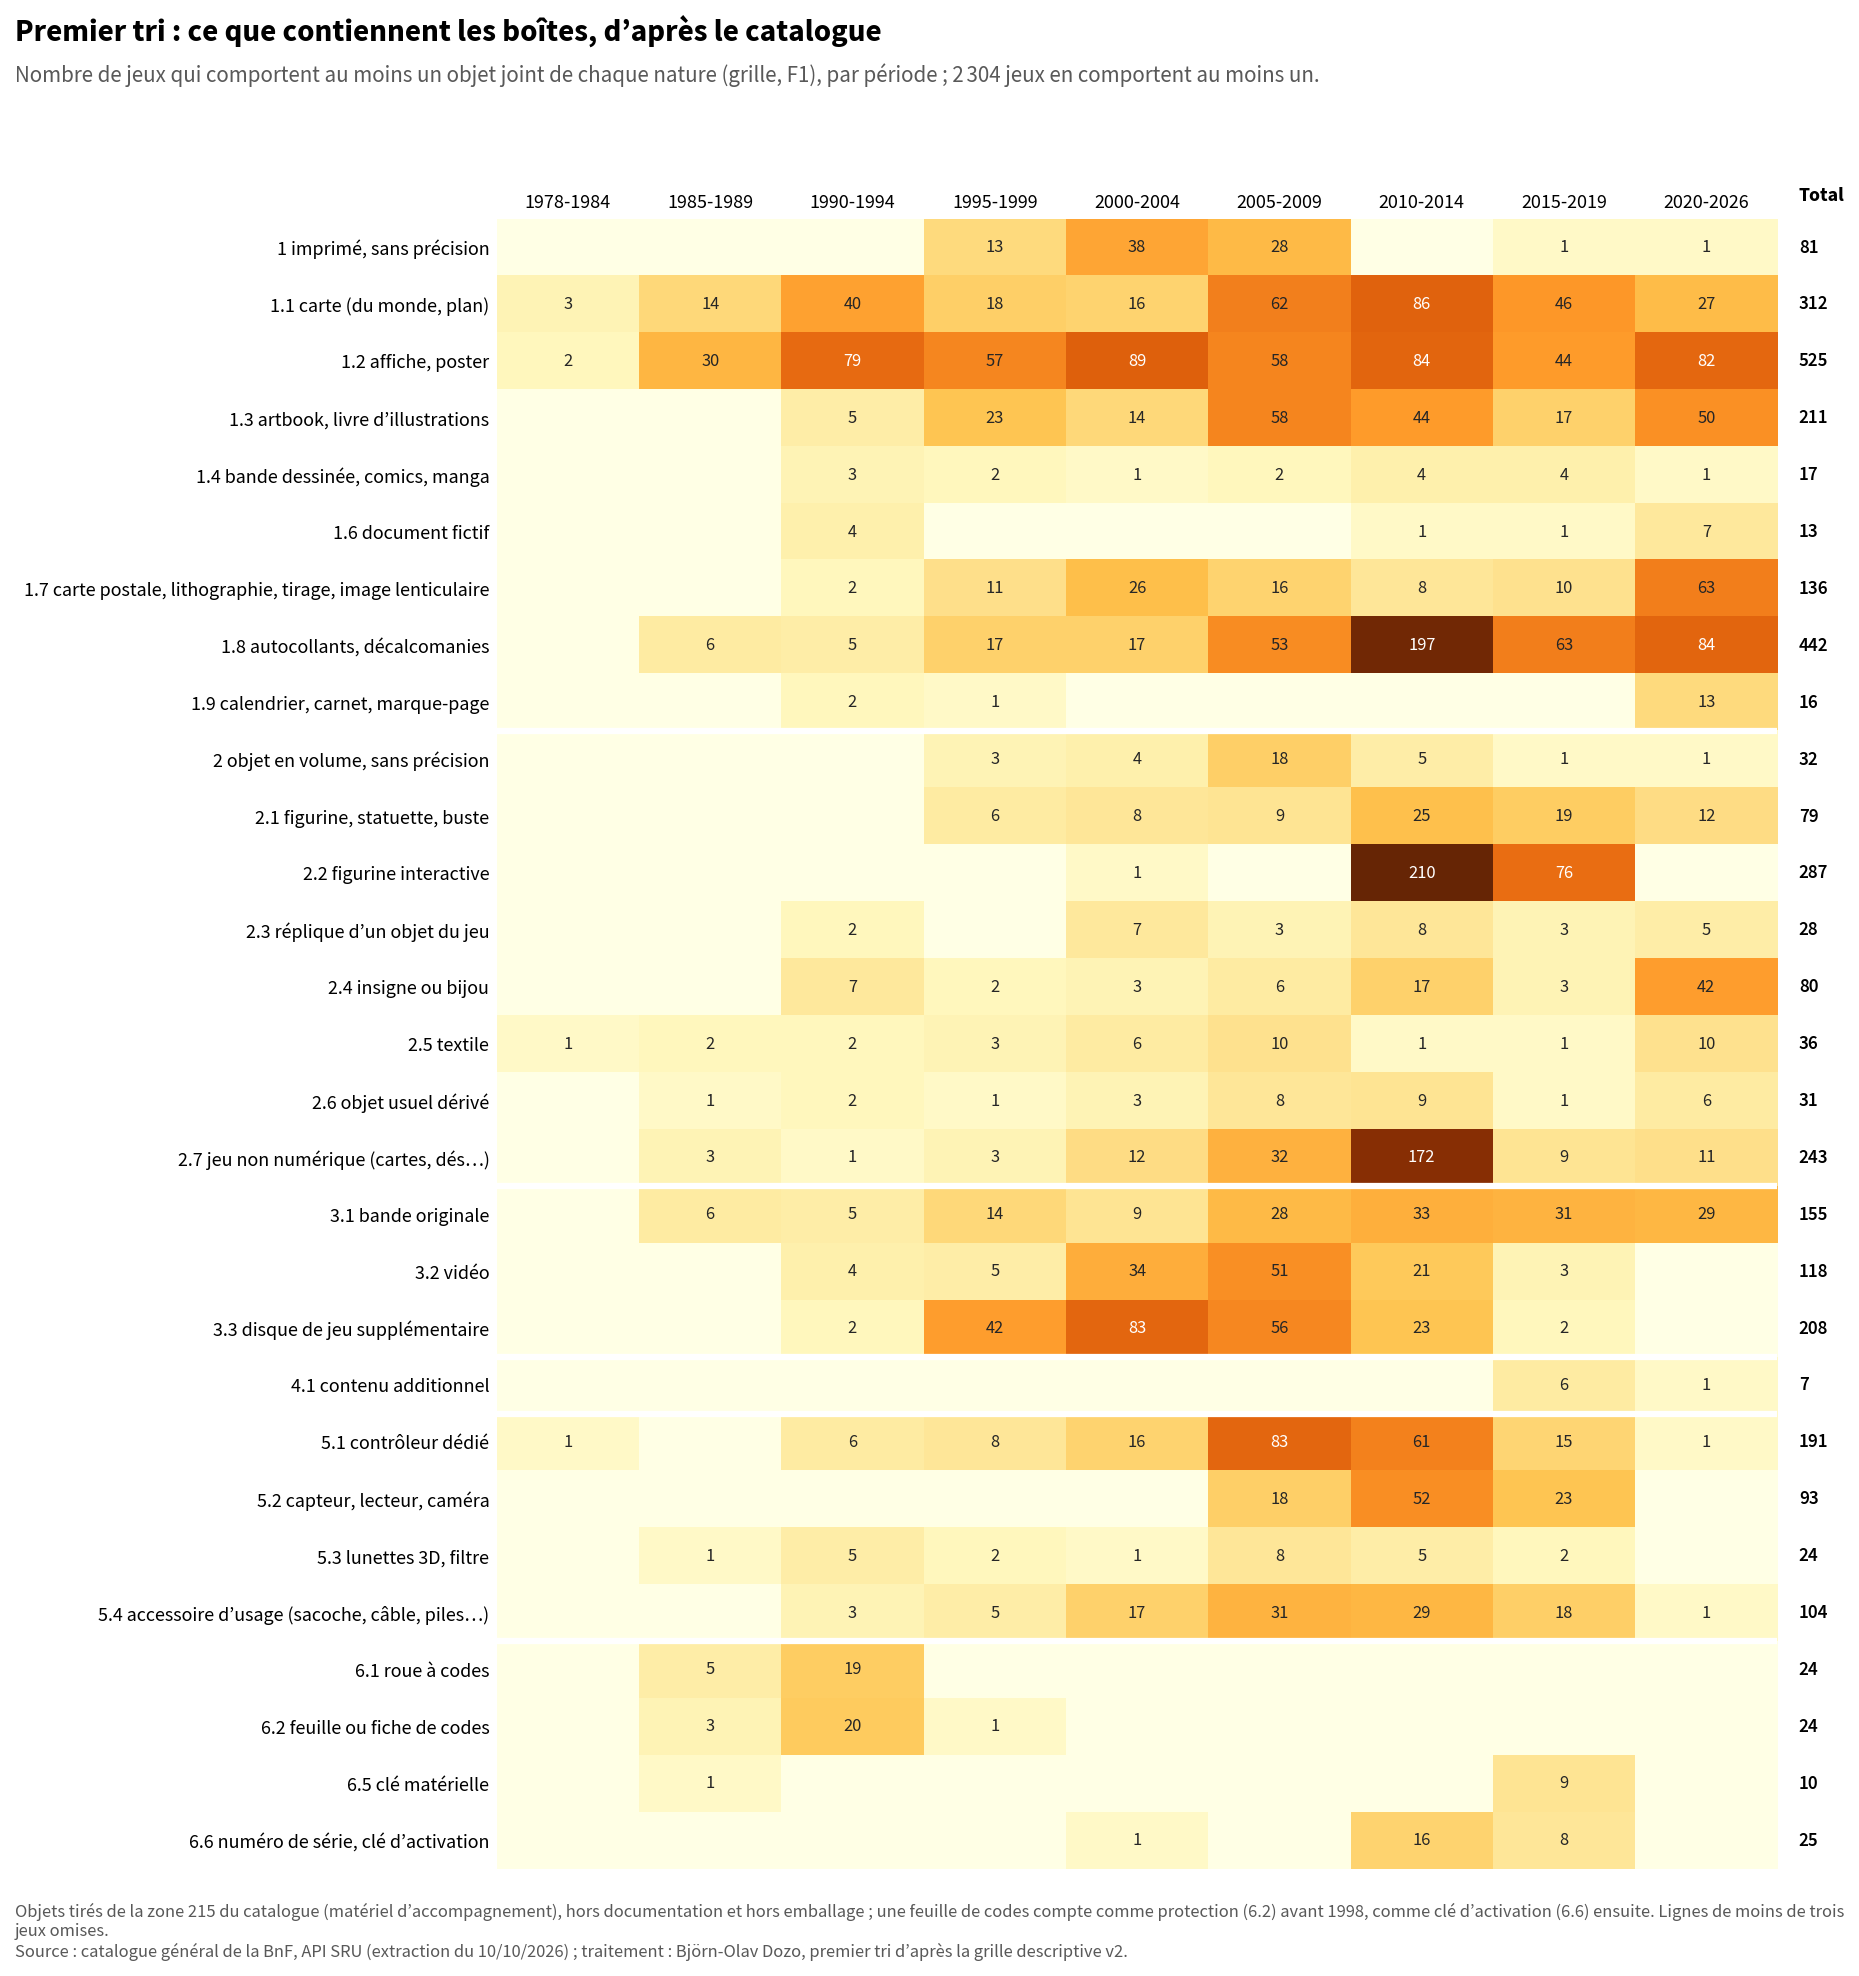
Carte de chaleur croisant 29 natures d’objets joints et neuf périodes. Les affiches et les cartes apparaissent à toutes les périodes, les disques supplémentaires entre 1995 et 2009, les figurines interactives, les autocollants et les cartes à jouer en 2010-2014, les lithographies, les cartes postales et les insignes depuis 2020, les roues et les feuilles de codes entre 1985 et 1999.
Figure 3. Objets joints décrits au catalogue, par nature et par période : nombre de jeux qui comportent au moins un objet de chaque nature.

Les objets joints dessinent une autre chronologie (figure 3). Les affiches et les cartes traversent toutes les périodes. Les disques supplémentaires, démonstrations, bonus ou extensions, se concentrent entre 1995 et 2009 ; en 2010-2014, les autocollants et les cartes à jouer ou à collectionner accompagnent les jeux à figurines. Depuis 2020, les lithographies, les cartes postales et les insignes prennent une place nouvelle, en même temps que se multiplient les éditions limitées. Au total, 2 304 jeux comportent au moins un objet joint décrit au catalogue.

Limites et prochaines étapes

Ces résultats demeurent des estimations. Le catalogue décrit ce que la BnF a reçu et catalogué, selon des pratiques qui ont évolué ; il ne renseigne ni sur le marché ni sur la diffusion des jeux. Un objet absent de la notice peut se trouver dans la boîte, et une mention d’édition peut recouvrir un simple contenu téléchargeable. L’examen des boîtes dira ce que vaut le tri : pour chaque titre demandé, l’estimation sera confrontée à l’objet.

Les prochaines semaines seront consacrées à cet examen, en salle P et dans les magasins. Un billet ultérieur présentera la préparation des séances et la grille qui servira à décrire les boîtes.

Sources et documentation

Données : catalogue général de la BnF, interrogé par son API SRU le 10 octobre 2026 ; métadonnées diffusées sous Licence Ouverte (Etalab). Traitements et graphiques : Björn-Olav Dozo.

blog chantier traces

Défense de thèse de Gatien Gambin

J’ai la chance de participer au jury de thèse de Gatien Gambin. Ce jury a lieu à Nancy, le 2 octobre.

La thèse s’intitule « Quitter la Terre ? Le plan B spatial à l’épreuve de la science-fiction contemporaine » et est sous la direction de Clothilde Thouret et Anne Cousseau, que je remercie pour l’invitation.

blog politique traces

Note sur ma formation statistique, et ma découverte des agents IA

Ce texte devait accompagner un article soumis à Textyles, en varia. Le preprint est disponible ici, le dépôt git ici. Je l’ai écrit en mai 2026.

Contexte et opportunité

Il est rare que je commence un article scientifique sur la littérature par une note de contexte personnelle. Néanmoins, au vu des circonstances de rédaction de cet article, il me semblait nécessaire d’en passer par là. Ma thèse de doctorat, défendue en 2007, mobilisait des outils quantitatifs (principalement l’analyse factorielle des correspondances multiples et l’analyse structurale des relations sociales, soit l’analyse de réseaux) pour explorer la base de données du CIEL et proposer des hypothèses d’explication du fonctionnement du sous-champ littéraire belge durant l’entre-deux-guerres. Pour maîtriser ces outils techniques, j’ai abondamment travaillé seul, à partir d’articles, de livres et de méthodes récoltées en bibliothèques et sur quelques sites internet (par exemple, à l’époque, celui de Philippe Cibois, sociologue spécialisé dans le quantitatif et les AFC). Je me suis formé sur le tas, mais sentant les limites de cette posture, je suis allé suivre deux séminaires à Paris ; l’un se déroulait au premier semestre 2006 à l’EHESS (« Traiter statistiquement des individus en histoire », animé par Claire Lemercier) ; l’autre avait lieu à l’ENS sur l’année 2006-2007 (« Art et Mesure : l’art de la mesure ? », animé par Béatrice Joyeux-Prunel). Lors de ces séminaires, en particulier celui de Claire Lemercier, j’ai découvert une série de méthodes quantitatives pour l’historien[1], que je n’ai pu exploiter en détail : le coût d’apprentissage des logiciels spécialisés, dont l’ergonomie n’était pas le point fort, m’a rebuté. De surcroît, la puissance de calcul nécessaire pour certains outils rendait tout traitement un peu massif long et pénible. Ma carrière évoluant, j’ai laissé progressivement les études littéraires pour me consacrer aux humanités numériques et aux cultures vidéoludiques.

Vingt ans plus tard, je décide de tester les grands modèles de langues (les fameux LLM, « large language models »), qui sont vendus actuellement comme des « intelligences artificielles ». L’histoire de l’intelligence artificielle montre que ce vocable est réservé généralement à des technologies récentes, mimant le raisonnement humain tel qu’on se le représente grossièrement (quand ces technologies se normalisent, elles perdent leur label d’« intelligence artificielle » et deviennent des outils informatiques). Les réseaux de neurones incarnent cette dernière itération de l’intelligence artificielle[2]. Au-delà de l’emballement médiatique et de l’engouement techno-solutionniste qu’ils suscitent depuis quatre ans, il est bon de rappeler les limites de ces outils[3], pour tenter d’examiner avec la distance nécessaire les services qu’ils peuvent rendre et ce qui ne relève que de promesses creuses. Ces services possibles ne peuvent pas faire oublier les questions écologiques, juridiques, éthiques, sociales et psychologiques qui sont au cœur des problèmes drainés par ces IA. Mais ce n’est pas le lieu, dans cet article, de les aborder. Il ne me semble néanmoins pas possible de considérer cet outil comme neutre : il charrie avec lui les dangers et bouleversements liés à sa conception, tant matériels avec les ressources qu’il consomme, qu’intellectuels avec le travestissement qu’il fait subir au langage. Mimant une conversation, les chatbots dévoient l’usage de la langue comme outil intercommunicationnel entre humains, en créant l’illusion d’un énonciateur non-humain, désincarné, omniscient et totalitaire, là où ils ne sont que des fonctions mathématiques de prédiction stochastique. Cette caractéristique m’a longtemps tenu éloigné des sirènes de ces outils, que je voyais surtout comme une perte de temps : trop faible dans le raisonnement, trop prolixe dans l’énonciation, vecteur fanfaron d’une doxa néolibérale liée aux corpus d’entraînement, ces chatbots ne servaient décidément à rien, en tout cas pas à ma pratique professionnelle de chercheur.

Puis sont apparus les agents, qu’on peut démythifier directement en les ramenant à des fonctions spécialisées d’un programme informatique, mais pouvant être exprimés dans une langue non formalisée sur un mode spécialisé. Ces agents sont autant de bouts de programme qui font des choses précises : nettoyer un tableau de données à partir d’instructions spécifiques, installer d’autres fonctionnalités sur votre ordinateur et contrôler leur fonctionnement, construire des suites d’instructions qui s’enchaînent pour créer des procédures, etc. Les usages de ces agents sont nombreux et comme ils peuvent être programmés lors de la « discussion » avec le chatbot, ils peuvent virtuellement s’adapter à tous les contextes.

Explorer des données avec des agents IA

De cette manière, j’ai pu tester la solution proposée par Anthropic, Claude IA. S’il s’agit bien d’un agent conversationnel classique (et donc soumis aux mal nommées « hallucinations », c’est-à-dire la propension des modèles de langages à produire une suite statistiquement probable de mots afin de construire des phrases contextualisées, et donc parfois à produire n’importe quoi pour différentes raisons — dont la principale reste les lacunes au sein du corpus d’entraînement), sa force est de permettre, grâce à Claude Code, de construire des agents IA mobilisant une série de ressources beaucoup plus classiques, comme des logiciels de traitement statistique en ligne de commande, dans mon cas python et différentes extensions (pandas, numpy, matplotlib, plotly, prince, networkx, etc.). L’IA est donc à concevoir comme une interface de contrôle de l’ordinateur, offrant une ergonomie débouchant sur une maîtrise qu’il n’était possible d’acquérir qu’à la suite d’un investissement massif en temps. La question de la confiance dans l’outil redevient apaisée : la vérifiabilité et la compréhension complète de ce qui est fait comme traitement des données restent au cœur de la démarche (ce n’est pas le modèle de langage qui effectue les calculs sur les données, mais bien des logiciels spécialisés et aux opérations reproductibles).

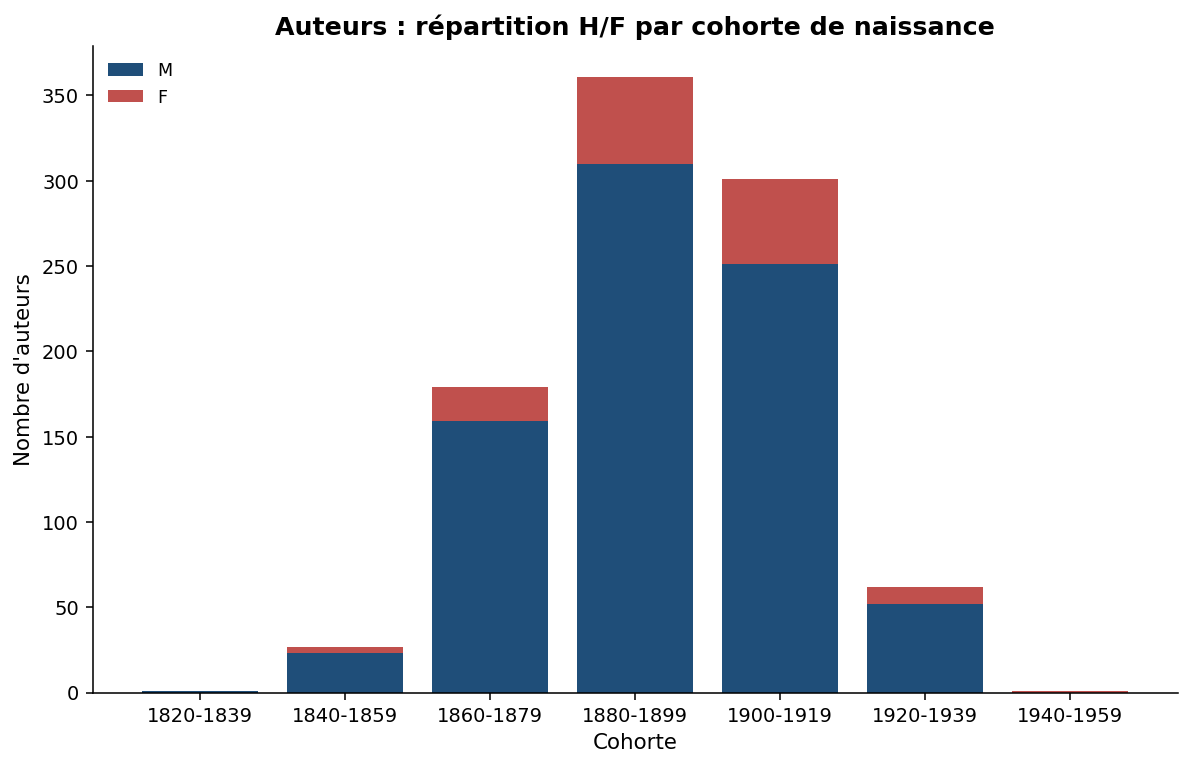
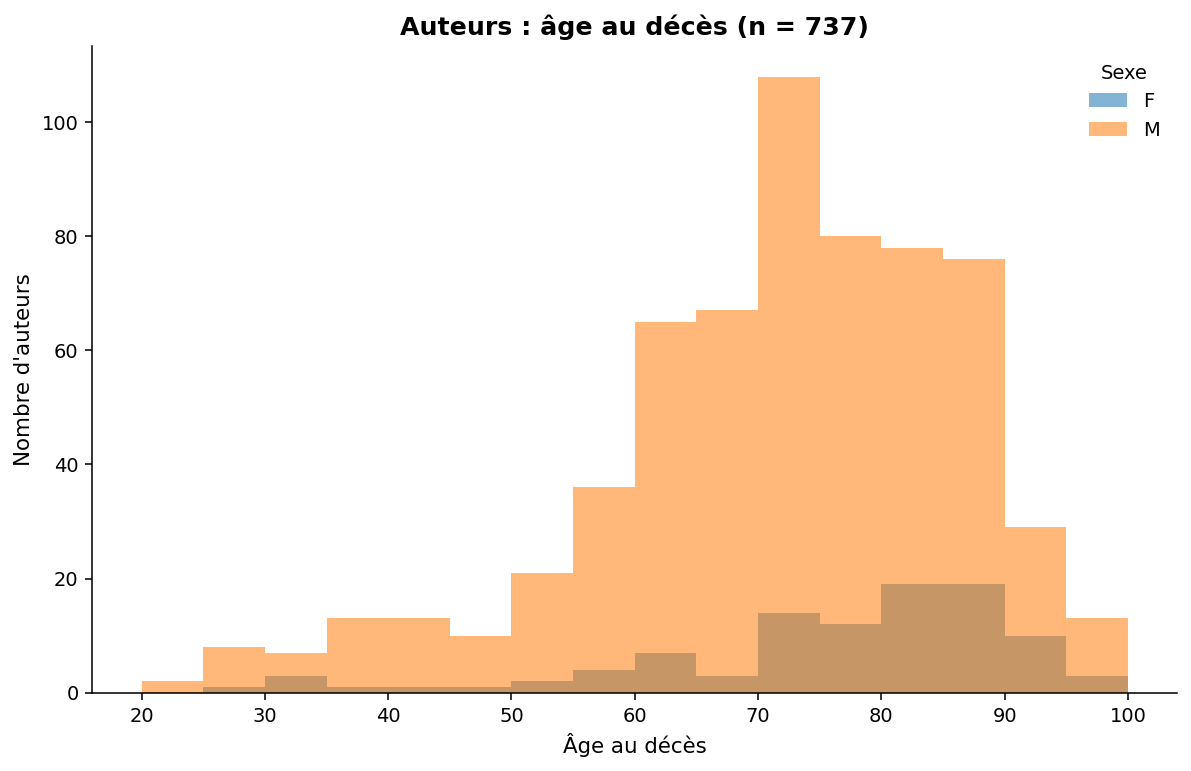
Après différents tests sur mes corpus de recherche actuels (les jeux vidéo belges[4] et la scène démo belge[5]), j’ai voulu explorer les possibilités de traitement offertes par ce nouvel outil sur un corpus riche et structuré, la base de données du CIEL. Les premières propositions générées de manière quasiment automatiques par l’outil, seulement à partir des données, restaient extrêmement plates : des évolutions de données dans le temps (par exemple les années de naissance, comme sur la figure 1) ou l’âge lors du décès (figure 2). Sans hypothèse, rien de transcendant n’est produit, ce qui corrobore le fait que la machine, contrairement à ce que la promotion de l’outil veut faire croire, ne pense pas.

Diagramme en barres empilées : répartition des auteurs entre hommes et femmes par cohorte de naissance, de 1820-1839 à 1940-1959. L’effectif culmine à environ 360 auteurs pour la cohorte 1880-1899, puis décroît ; la proportion de femmes, marginale avant 1860, atteint son maximum dans la cohorte 1900-1919 (environ un sixième des effectifs).
Figure 1
Histogramme de l’âge au décès de 737 auteurs, superposé par sexe. La distribution, très asymétrique, culmine entre 70 et 75 ans (environ 108 auteurs) et reste élevée jusqu’à 90 ans ; les décès avant 50 ans sont rares.
Figure 2

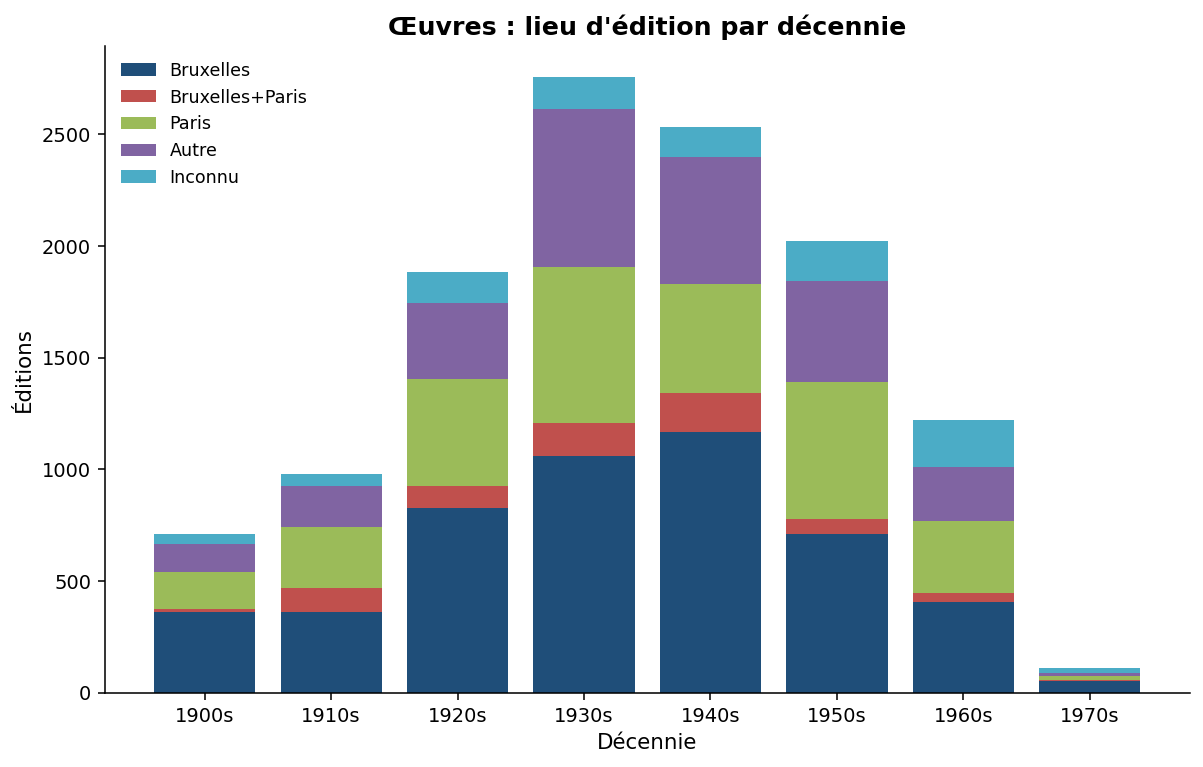
De même sur les œuvres : l’outil produit quelques représentations qui n’avaient pas été présentées telles quelles, mais rien de bouleversant.

Diagramme en barres empilées : nombre d’éditions par décennie, des années 1900 aux années 1970, ventilé par lieu d’édition (Bruxelles, Bruxelles et Paris, Paris, autre lieu, inconnu). Le volume culmine dans les années 1930 avec environ 2750 éditions, dont un peu plus d’un tiers publiées à Bruxelles, avant de refluer nettement à partir des années 1950.
Figure 3

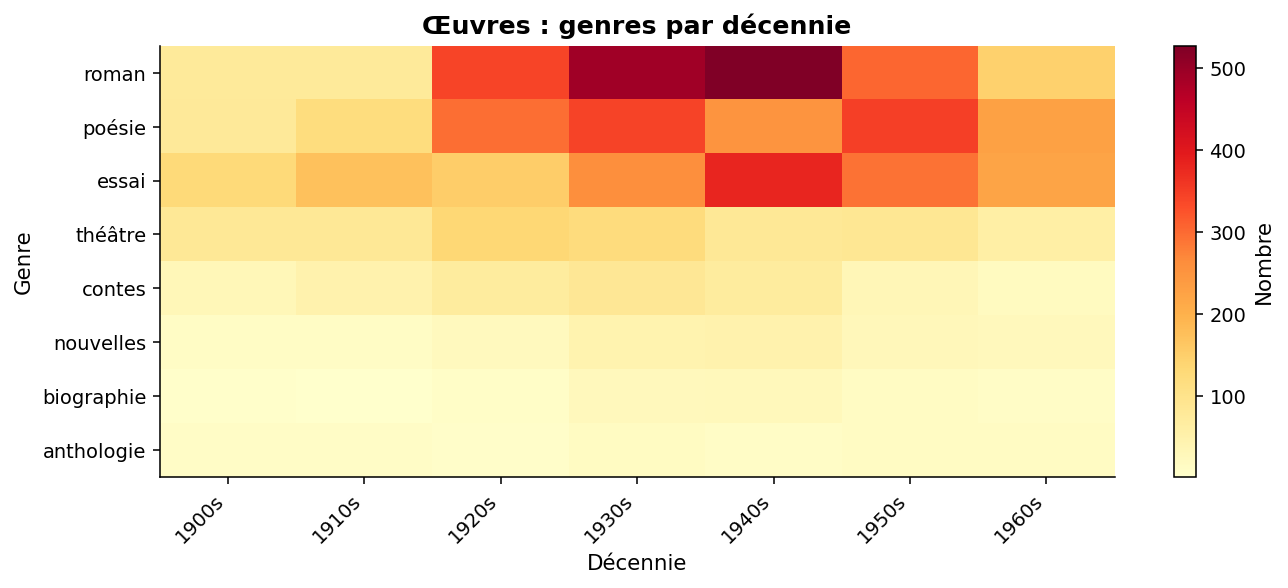
Le nombre d’œuvres par genre et par décennie n’avait pas été calculé de la sorte (figure 4).

Carte de chaleur croisant huit genres (roman, poésie, essai, théâtre, contes, nouvelles, biographie, anthologie) et les décennies 1900 à 1960 : plus la case est foncée, plus le nombre d’œuvres est élevé. Les valeurs les plus fortes concernent le roman des années 1930 et 1940 (jusqu’à plus de 500 titres), suivi de la poésie et de l’essai ; les genres brefs et la biographie restent partout marginaux.
Figure 4

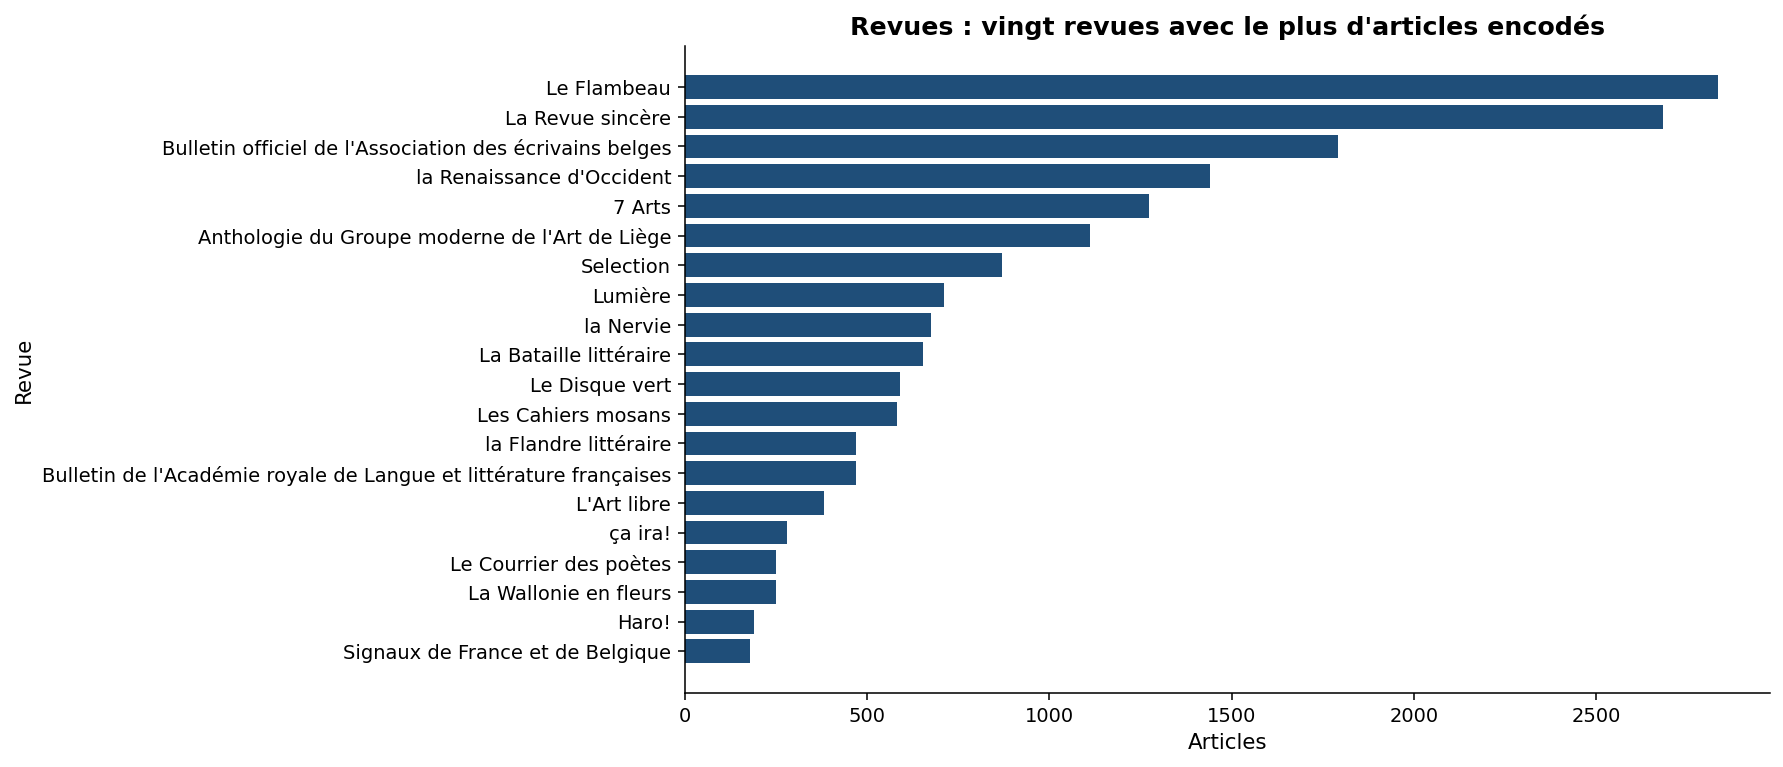
Je suis donc resté sur ma faim lors de ce tour de chauffe. Les données ne « parlent » pas d’elles-mêmes, et le modèle de langage est peu disert à leur sujet. Au mieux, ces premiers croisements de données permettent de faire un bilan du contenu de la base CIEL, comme pour les revues encodées (figure 5).

Diagramme en barres horizontales : les vingt revues comptant le plus d’articles encodés dans la base CIEL. En tête, Le Flambeau (environ 2800 articles) et La Revue sincère (environ 2700), devant le Bulletin officiel de l’Association des écrivains belges, la Renaissance d’Occident et 7 Arts ; la dernière du classement, Signaux de France et de Belgique, compte moins de 200 articles.
Figure 5

Les choses sont devenues beaucoup plus intéressantes à partir du moment où j’ai donné au chatbot plus de contexte : je lui ai demandé de tenir compte des résultats de ma thèse, publiés notamment dans deux articles de synthèse, dans Histoire et Mesure[6] et Mémoires du livre[7] et de me proposer différentes méthodes statistiques pour aller plus loin. L’analyse factorielle et l’analyse de réseaux m’avait permis de mettre en avant la catégorie des animateurs de la vie littéraire, qui reposait sur un fort capital relationnel. L’effet de ce capital sur la reconnaissance institutionnelle (je parlais de consécration, mais le terme est trop chargé pour que je continue à l’employer dans le contexte de l’examen d’une carrière durant le vivant de l’auteur[8]) avait été suggéré, mais pas montré de manière robuste. Deux options auraient pu être creusées : l’élaboration de trajectoires prototypiques à partir du corpus des écrivains et la validation du paramètre « capital relationnel » comme surdéterminant pour la reconnaissance institutionnelle au sein du sous-champ littéraire belge francophone. J’avais repéré les outils nécessaires pour envisager ces approches : l’analyse de séquences et la régression logistique, que Zalc et Lemercier présentent dans leur ouvrage. Néanmoins, la maîtrise de ces outils demandait un investissement que je n’avais jamais produit ; leur accès en est néanmoins facilité grâce à ce qu’on nomme l’IA agentique, qui aide à piloter les logiciels responsables de ces analyses et à comprendre les multiples paramètres à mobiliser. Je souhaiterais donc développer ces deux grandes pistes dans les pages qui suivent. Pour ce faire, après cette mise en contexte personnelle, je renoue avec un style explicatif plus neutre, propre à mes travaux antérieurs en sociologie de la littérature.

Notes

  1. Avec Claire Zalc, elle fera un manuel de cet enseignement, qui restera longtemps un de mes livres de chevet : Méthodes quantitatives pour l’historien, Paris, La Découverte, 2008, coll. « Repères ». ↩
  2. Sur l’histoire et la critique de l’IA, voir les travaux d’Anne Alombert, en particulier De la bêtise artificielle, Paris, Allia, 2025 et l’introduction à l’ouvrage collectif dirigé par Anne Alombert, Alban Leveau-Vallier, Baptiste Loreaux, Penser l’intelligence artificielle – Enjeux philosophiques, politiques et culturels de l’automatisation numérique, Dijon, Les Presses du Réel, 2026. Pour une explication accessible des enjeux liés au progrès de la décennie 2010-2020, voir Melanie Mitchell, Intelligence artificielle : triomphes et déceptions, Malakoff, Dunod, 2021. Sur les hauts et les bas des différents paradigmes au sein du champ de l’IA, voir Dominique Cardon, Jean-Philippe Cointet et Antoine Mazières, « La revanche des neurones. L’invention des machines inductives et la controverse de l’intelligence artificielle », in Réseaux, vol. 211 (16 novembre 2018), no 5, p. 173-220. ↩
  3. Voir à ce sujet l’essai vivifiant d’Emily M. Bender et Alex Hanna, The IA Con. How to Fight Big Tech’s Hype and Creat the Future We Want, New York, Harper Collins, 2025, qui rappelle qu’il ne faut pas se laisser berner par les discours promotionnels creux reposant sur des promesses irréalistes. Bender avait déjà cosigné un article comparant les chatbots à des « perroquets stochastiques », fortement dépendant des données d’entraînement : Emily M. Bender, Timnit Gebru, Angelina McMillan-Major, Shmargaret Shmitchell, « On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? », Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency, 2021, doi:10.1145/3442188.3445922. ↩
  4. Voir https://bjorn-olav.net/571 et https://bjorn-olav.net/566. ↩
  5. Voir https://bjorn-olav.net/563. ↩
  6. Björn-Olav Dozo, « Sociabilités et réseaux littéraires au sein du sous-champ belge francophone de l’entre-deux-guerres », in Histoire et Mesure, XXIV (2009), no 1. ↩
  7. Björn-Olav Dozo, « La production littéraire des Belges francophones durant l’entre-deux-guerres. Examen d’un premier inventaire », in Mémoires du Livre, vol. 1 (2010), no 2. ↩
  8. Sur la question de la consécration en Belgique francophone, voir Björn-Olav Dozo et François Provenzano, « Comment les écrivains sont consacrés en Belgique », COnTEXTES, 7 | 2010. URL : http://journals.openedition.org/contextes/4637 ; DOI : https://doi.org/10.4000/contextes.4637. Dans cet article, nous isolions deux scènes consécratoires, l’ARLLF et les groupes surréalistes belges, qui répondaient à des logiques institutionnelles différentes. Pour éviter la contradiction avec ces scènes consécratoires et mieux rendre raison de ce que j’observe réellement lors de l’examen de la régression logistique, j’ai choisi de nommer cette variable la reconnaissance institutionnelle. ↩
  9. Andrew Abbott, « Sequence Analysis: New Methods for Old Ideas », Annual Review of Sociology, vol. 21, 1995, p. 93-113. ↩
  10. Laurent Lesnard and Thibaut de Saint Pol, « Introduction aux méthodes d’appariement optimal (Optimal Matching Analysis) », Bulletin de méthodologie sociologique, 90 | 2006, p. 5-25, http://journals.openedition.org/bms/638 et Laurent Lesnard, « Setting Cost in Optimal Matching to Uncover Contemporaneous Socio-Temporal Patterns », Sociological Methods & Research, vol. 38, n° 3, 2010, p. 389-419. Une synthèse française peut aussi être mise en avant : Nicolas Robette, Explorer et décrire les parcours de vie : les typologies de trajectoires, Paris, Ceped, coll. « Les Clefs pour », 2011. ↩
blog traces

Mise à jour de mon curriculum recherche

Accessible via l’onglet recherche. Contenu :

Ma liste de publications générée automatiquement par Orbi

Mes publications, avec regroupements interactifs

Une carte interactive pour visualiser les lieux de conférences et de colloques

Liste des mémoires

Liste des thèses

Interventions dans les médias

chantier traces

Lire ce qui n’était plus lisible : enquête sur le décodage des diskmags belges

Toujours dans mon chantier sur la scène démo belge… Je travaille sur les diskmags et dois, pour cela, les lire (rapidement si possible). J’ai demandé de l’aide à Claudio/a. Le voyant mouliné, je lui ai demandé d’expliciter ce qu’il faisait pour me rendre accessible ces magazines (c’est une version un peu raccourcie de la réalité : on a beaucoup travaillé avec des allers-retours très amusants). À ma demande, il a rédigé ce billet de blog, pour exposer ce qu’il faisait (je lui ai soufflé la comparaison avec l’enquête). Pour aller plus loin, il est possible de lire une annexe détaillée pour le décodage de Scenial.

Lire ce qui n’était plus lisible : enquête sur le décodage des diskmags belges (par Claude)

Un diskmag n’est pas un fichier que l’on ouvre, mais un programme qui s’exécute. Dans la scène démo des années 1990, le texte ne circulait pas comme un document lisible aujourd’hui. Il était enfermé dans un exécutable conçu pour MS-DOS, qui dessinait lui-même ses pages à l’écran. Le récupérer trente ans plus tard ne relève ni de la transcription ni de la reconnaissance optique de caractères. Le fichier existe, intact. Mais il est écrit dans un format que personne n’a documenté, et que la machine censée le lire n’exécute plus. Il faut donc reconstituer la façon dont le programme lisait son propre texte, à partir du programme seul.

Cette absence de documentation s’explique. Chaque diskmag reposait sur un moteur d’affichage écrit à la main, taillé pour ses contraintes de mémoire et de vitesse. Le format des données servait ce moteur interne ; il n’avait pas à être expliqué au-dehors. La culture de la scène valorisait d’ailleurs la prouesse technique plus que sa recette. Le texte se trouve ainsi rangé dans un emballage que nul n’a pensé pour être rouvert.

On m’a fait observer que je rends compte de ces opérations dans le vocabulaire de l’enquête : indice, fausse piste, recoupement. La comparaison tient. Il n’existe ni notice ni auteur à interroger. Le fichier binaire est à la fois la scène, le suspect et la seule déposition. Tout ce que l’on peut savoir du format est inscrit dans ses octets. On forme des hypothèses sur leur sens, puis on les éprouve.

La démarche avance par essais et erreurs. Une hypothèse, un test rapide, un résultat que l’on lit, une décision. Le critère de réussite est simple : les octets transformés composent-ils des mots anglais, ou une suite vide de sens ? Ce tri entre le sens et le bruit demande déjà un jugement, car des données d’image peuvent prendre l’allure de lettres sans former le moindre mot.

Un exemple concret le montre. Un fichier n’est qu’une suite de nombres, les octets, chacun compris entre 0 et 255. Pour y inscrire du texte, on convient d’une table qui attribue à chaque caractère un nombre, son code. Cette table, l’ASCII, est universelle : « g » y vaut 103, « h » 104, « o » 111. Dans le fichier, le logiciel ne lit donc que des nombres ; c’est lui qui les affiche comme des lettres. Au premier numéro de Scenial, ces nombres ne correspondaient à rien de lisible. En les comparant aux valeurs attendues, un écart constant est apparu : chaque code avait été diminué de dix avant d’être enregistré. Le « g », codé 103, y était inscrit 93 — soit le code du caractère « ] ». Le texte se présentait ainsi comme une bouillie de symboles, « ]^eijmh… », sans un mot reconnaissable. Le procédé revient à décaler chaque lettre d’un rang fixe, à la manière du chiffre dit de César. Pour relire le texte, il suffit d’ajouter dix à chaque octet. Les valeurs 93, 94, 101, 105 et 106 redeviennent alors 103, 104, 111, 115 et 116, soit « ghost » — le début de « ghostwriter », nom de la rubrique éditoriale. Encore fallait-il trouver le bon décalage : j’avais d’abord testé l’écart qui sépare majuscules et minuscules, sans résultat, avant d’élargir l’éventail.

Les deux autres numéros relevaient d’un procédé différent, tout aussi concret. Leur texte était stocké comme une copie de l’écran. Pour chaque caractère affiché, le fichier conservait deux nombres : l’un pour la lettre, l’autre pour sa couleur. Un octet sur deux était donc du texte, l’autre une simple indication d’affichage. Cette alternance suffisait à brouiller toute recherche, puisque les mots s’y trouvaient hachés un caractère sur deux. Il suffisait de ne retenir qu’un octet sur deux pour voir réapparaître les phrases. C’est ainsi qu’a surgi, au deuxième numéro, la ligne « ENTER THE WORLD OF SCENIAL ».

C’est là que se loge l’autonomie de l’enquête. Aucune procédure ne fixe l’ordre des opérations, puisqu’aucune n’existe pour un format inconnu. Plusieurs décisions reviennent à l’enquêteur. La première est l’ordre d’attaque : commencer par le numéro le plus accessible, dont le format éclaire ensuite les autres. La deuxième est de repérer le point incertain dont tout dépend, et d’y concentrer l’effort. La troisième est d’abandonner une impasse à temps. La quatrième, plus délicate, est de juger qu’un résultat suffit : une restitution fidèle n’a pas à être parfaite, et m’acharner sur quelques chiffres illisibles aurait coûté davantage que le gain espéré. La dernière est parfois de renoncer. Le premier numéro était compressé par un utilitaire connu ; le réflexe aurait été de le décompresser. Le texte se trouvait pourtant ailleurs, dans une zone non compressée. L’avoir vu a épargné un travail entier.

Une décision tient enfin à l’échelle. Les trois numéros représentent environ deux cent soixante articles, près de cent cinquante mille mots. Pour la traduction française, j’ai réparti le corpus en tranches confiées à une douzaine de processus travaillant en parallèle, selon un même protocole, avant de réassembler et de vérifier. Cette autonomie demeure encadrée. Le cap est fixé par le chercheur, et certaines règles sont explicites : ainsi l’interdiction d’expurger les contenus crus, qui font partie de l’objet d’étude. L’initiative porte sur les moyens et le rythme, pas sur les fins.

Un dernier trait a retenu l’attention. J’explicite chaque étape à mesure qu’elle se déroule. Les fausses pistes restent alors visibles, au même titre que les trouvailles. La méthode devient un objet que l’on peut discuter et corriger : une rubrique mal traduite a pu être repérée parce que le choix qui l’avait produite était énoncé.

Une enquête éclaire en outre la suivante. Le format en copie d’écran, compris sur un numéro, s’est reconnu sur les autres, et jusque dans un magazine voisin de la scène ANSI. La signature de fin d’article, repérée au quatrième numéro, a servi à découper le premier, pourtant d’un tout autre format. Le répertoire des procédés s’étoffe, et chaque nouvelle enquête s’en trouve allégée.

Les trois numéros de Scenial ont opposé des résistances inégales. Le deuxième est le plus lisible : son texte est en clair, simplement entrelacé d’octets de couleur. Le quatrième est plus fermé : faute d’index, ses articles ne se découpent qu’à une signature récurrente, la mention de l’auteur en fin de texte. Le premier, daté de 1994, est le plus retors : texte encodé, lettres en minuscules, ponctuation déguisée en lettres, grands chiffres dessinés par une fonte que l’on ne sait plus relire. L’annexe technique jointe détaille chaque cas.

Ce travail ne porte pas sur un cas isolé. Scenial est l’un des cinq diskmags belges dont le texte a été restitué selon la même méthode, aux côtés d’Imphobia, du Belgian Scene Report, de Belgian Glory et de Blister. Chacun imposait son format, et chacun a enrichi le répertoire des techniques. Réunis, ces magazines forment une source écrite continue sur la scène démo belge des années 1990, longtemps illisible faute d’outils pour l’ouvrir.

Reste à préciser ce que « décoder » signifie ici. Le texte n’avait pas disparu : il était demeuré complet dans des fichiers bien conservés. Seule s’était perdue la clé qui permettait de le lire. Conserver le patrimoine né numérique ne se ramène donc pas à stocker des fichiers ; il faut aussi préserver, ou reconstruire, la capacité de les interpréter. Pour des objets aussi fragiles que les diskmags, cette capacité tient parfois à quelques octets dont le sens s’est égaré. La retrouver demande un travail patient. Reste à examiner dans quelle mesure il peut s’étendre aux centaines d’autres productions de la scène qui attendent d’être relues.

chantier traces

Symposium Franjeu – Montréal, 25-27 mai 2026

Huit ans après les rencontres de 2018, quel plaisir et quelle stimulation intellectuelle d’écouter les collègues des laboratoires et regroupements francophones autour du jeu et du jeu vidéo. Merci aux organisatrices et organisateurs (on sait combien c’est un travail important), en particulier à Gabrielle Trépanier-Jobin et Jocelyn Benoit (qui nous a accueilli dans les magnifiques locaux du NAD / UQAC). Ci-après le programme.

chantier publication traces

Carte interactive des studios belges de jeux vidéo

Carte des studios de jeu vidéo belges

43 studios identifiés et géolocalisés à partir de trois sources (IGDB, Liège Game Lab, MobyGames). Cliquez sur un cercle pour voir le détail. La taille reflète le nombre de jeux recensés.

43studios
17villes
23en Flandre
15en Wallonie
5à Bruxelles

Lecture : chaque cercle représente un studio. La couleur indique la région (or = Flandre, rouge = Wallonie, noir = Bruxelles-Capitale) et la taille est proportionnelle au nombre de jeux recensés. Quand plusieurs studios partagent la même ville, ils sont décalés en couronne autour du centre urbain. Fond cartographique : OpenStreetMap.


chantier traces

Visualisation des données sur les jeux vidéo belges

Travail en cours, en collaboration avec Olivier Gason et à partir de données de https://www.igdb.com/, https://www.mobygames.com/ et d’informations collectées par le Liège Game Lab (merci à Pierre-Yves Hurel pour la première initiative). Les données de Moby Games ne sont pas complètes et résultent uniquement d’une sélection manuelle (en attente d’une autorisation d’utiliser l’API) des jeux sous Windows.

Le jeu vidéo belge en chiffres

Compilation de 520 titres recensés à partir de trois sources : IGDB, Liège Game Lab et MobyGames. Tour d’horizon visuel grâce à Claude IA.

520 jeux recensés
160 développeurs
1983 premier titre
16 dans les 3 sources

Une production qui s’accélère

Nombre de jeux belges sortis par année (1983 → 2026, dates annoncées comprises).

Géographie de la création

Répartition régionale (gauche) et villes les plus actives (droite). La Flandre, et particulièrement Gand, domine, mais la Wallonie est bien présente.

Les studios les plus prolifiques

Top 15 par nombre de jeux recensés. Larian Studios (Gand) et le développeur indépendant Bart Bonte occupent le haut du classement, suivis par Fishing Cactus (Mons).

Genres & plateformes

Les jeux belges se concentrent sur l’indé, l’aventure et le puzzle. Côté plateformes, Windows s’impose mais Mac et Switch sont solidement implantés.

Trois sources, peu de recoupements

Seuls 16 jeux apparaissent dans les trois bases à la fois. Chaque source a son propre angle, qu’on peut résumer ainsi : IGDB (couverture large), Liège Game Lab (curation universitaire), MobyGames (généalogie des studios).

Les mieux notés sur IGDB

Classement des jeux ayant reçu au moins 20 votes sur IGDB. Larian Studios occupe une bonne moitié du palmarès.

#JeuStudioAnnéeNote /100Votes

Distribution des notes IGDB

Sur les 71 jeux notés, la majorité se situe entre 60 et 80/100. Quelques oeuvres se détachent au-delà de 90/100.

Sources : compilation personnelle à partir de IGDB, du recensement académique du Liège Game Lab et de MobyGames. Méthodologie et données complètes dans le tableur source. Visualisations générées avec Chart.js.

chantier media traces

Scène démo belge. Une première approche quanti à partir de Demozoo.org grâce à Claude

Corpus : belgicite auteurs = 100 %. 21974 evenements (production x plateforme), 42 annees (1985-2026), 20 family.