Ce texte devait accompagner un article soumis à Textyles, en varia. Le preprint est disponible ici, le dépôt git ici. Je l’ai écrit en mai 2026.
Contexte et opportunité
Il est rare que je commence un article scientifique sur la littérature par une note de contexte personnelle. Néanmoins, au vu des circonstances de rédaction de cet article, il me semblait nécessaire d’en passer par là. Ma thèse de doctorat, défendue en 2007, mobilisait des outils quantitatifs (principalement l’analyse factorielle des correspondances multiples et l’analyse structurale des relations sociales, soit l’analyse de réseaux) pour explorer la base de données du CIEL et proposer des hypothèses d’explication du fonctionnement du sous-champ littéraire belge durant l’entre-deux-guerres. Pour maîtriser ces outils techniques, j’ai abondamment travaillé seul, à partir d’articles, de livres et de méthodes récoltées en bibliothèques et sur quelques sites internet (par exemple, à l’époque, celui de Philippe Cibois, sociologue spécialisé dans le quantitatif et les AFC). Je me suis formé sur le tas, mais sentant les limites de cette posture, je suis allé suivre deux séminaires à Paris ; l’un se déroulait au premier semestre 2006 à l’EHESS (« Traiter statistiquement des individus en histoire », animé par Claire Lemercier) ; l’autre avait lieu à l’ENS sur l’année 2006-2007 (« Art et Mesure : l’art de la mesure ? », animé par Béatrice Joyeux-Prunel). Lors de ces séminaires, en particulier celui de Claire Lemercier, j’ai découvert une série de méthodes quantitatives pour l’historien[1], que je n’ai pu exploiter en détail : le coût d’apprentissage des logiciels spécialisés, dont l’ergonomie n’était pas le point fort, m’a rebuté. De surcroît, la puissance de calcul nécessaire pour certains outils rendait tout traitement un peu massif long et pénible. Ma carrière évoluant, j’ai laissé progressivement les études littéraires pour me consacrer aux humanités numériques et aux cultures vidéoludiques.
Vingt ans plus tard, je décide de tester les grands modèles de langues (les fameux LLM, « large language models »), qui sont vendus actuellement comme des « intelligences artificielles ». L’histoire de l’intelligence artificielle montre que ce vocable est réservé généralement à des technologies récentes, mimant le raisonnement humain tel qu’on se le représente grossièrement (quand ces technologies se normalisent, elles perdent leur label d’« intelligence artificielle » et deviennent des outils informatiques). Les réseaux de neurones incarnent cette dernière itération de l’intelligence artificielle[2]. Au-delà de l’emballement médiatique et de l’engouement techno-solutionniste qu’ils suscitent depuis quatre ans, il est bon de rappeler les limites de ces outils[3], pour tenter d’examiner avec la distance nécessaire les services qu’ils peuvent rendre et ce qui ne relève que de promesses creuses. Ces services possibles ne peuvent pas faire oublier les questions écologiques, juridiques, éthiques, sociales et psychologiques qui sont au cœur des problèmes drainés par ces IA. Mais ce n’est pas le lieu, dans cet article, de les aborder. Il ne me semble néanmoins pas possible de considérer cet outil comme neutre : il charrie avec lui les dangers et bouleversements liés à sa conception, tant matériels avec les ressources qu’il consomme, qu’intellectuels avec le travestissement qu’il fait subir au langage. Mimant une conversation, les chatbots dévoient l’usage de la langue comme outil intercommunicationnel entre humains, en créant l’illusion d’un énonciateur non-humain, désincarné, omniscient et totalitaire, là où ils ne sont que des fonctions mathématiques de prédiction stochastique. Cette caractéristique m’a longtemps tenu éloigné des sirènes de ces outils, que je voyais surtout comme une perte de temps : trop faible dans le raisonnement, trop prolixe dans l’énonciation, vecteur fanfaron d’une doxa néolibérale liée aux corpus d’entraînement, ces chatbots ne servaient décidément à rien, en tout cas pas à ma pratique professionnelle de chercheur.
Puis sont apparus les agents, qu’on peut démythifier directement en les ramenant à des fonctions spécialisées d’un programme informatique, mais pouvant être exprimés dans une langue non formalisée sur un mode spécialisé. Ces agents sont autant de bouts de programme qui font des choses précises : nettoyer un tableau de données à partir d’instructions spécifiques, installer d’autres fonctionnalités sur votre ordinateur et contrôler leur fonctionnement, construire des suites d’instructions qui s’enchaînent pour créer des procédures, etc. Les usages de ces agents sont nombreux et comme ils peuvent être programmés lors de la « discussion » avec le chatbot, ils peuvent virtuellement s’adapter à tous les contextes.
Explorer des données avec des agents IA
De cette manière, j’ai pu tester la solution proposée par Anthropic, Claude IA. S’il s’agit bien d’un agent conversationnel classique (et donc soumis aux mal nommées « hallucinations », c’est-à-dire la propension des modèles de langages à produire une suite statistiquement probable de mots afin de construire des phrases contextualisées, et donc parfois à produire n’importe quoi pour différentes raisons — dont la principale reste les lacunes au sein du corpus d’entraînement), sa force est de permettre, grâce à Claude Code, de construire des agents IA mobilisant une série de ressources beaucoup plus classiques, comme des logiciels de traitement statistique en ligne de commande, dans mon cas python et différentes extensions (pandas, numpy, matplotlib, plotly, prince, networkx, etc.). L’IA est donc à concevoir comme une interface de contrôle de l’ordinateur, offrant une ergonomie débouchant sur une maîtrise qu’il n’était possible d’acquérir qu’à la suite d’un investissement massif en temps. La question de la confiance dans l’outil redevient apaisée : la vérifiabilité et la compréhension complète de ce qui est fait comme traitement des données restent au cœur de la démarche (ce n’est pas le modèle de langage qui effectue les calculs sur les données, mais bien des logiciels spécialisés et aux opérations reproductibles).
Après différents tests sur mes corpus de recherche actuels (les jeux vidéo belges[4] et la scène démo belge[5]), j’ai voulu explorer les possibilités de traitement offertes par ce nouvel outil sur un corpus riche et structuré, la base de données du CIEL. Les premières propositions générées de manière quasiment automatiques par l’outil, seulement à partir des données, restaient extrêmement plates : des évolutions de données dans le temps (par exemple les années de naissance, comme sur la figure 1) ou l’âge lors du décès (figure 2). Sans hypothèse, rien de transcendant n’est produit, ce qui corrobore le fait que la machine, contrairement à ce que la promotion de l’outil veut faire croire, ne pense pas.
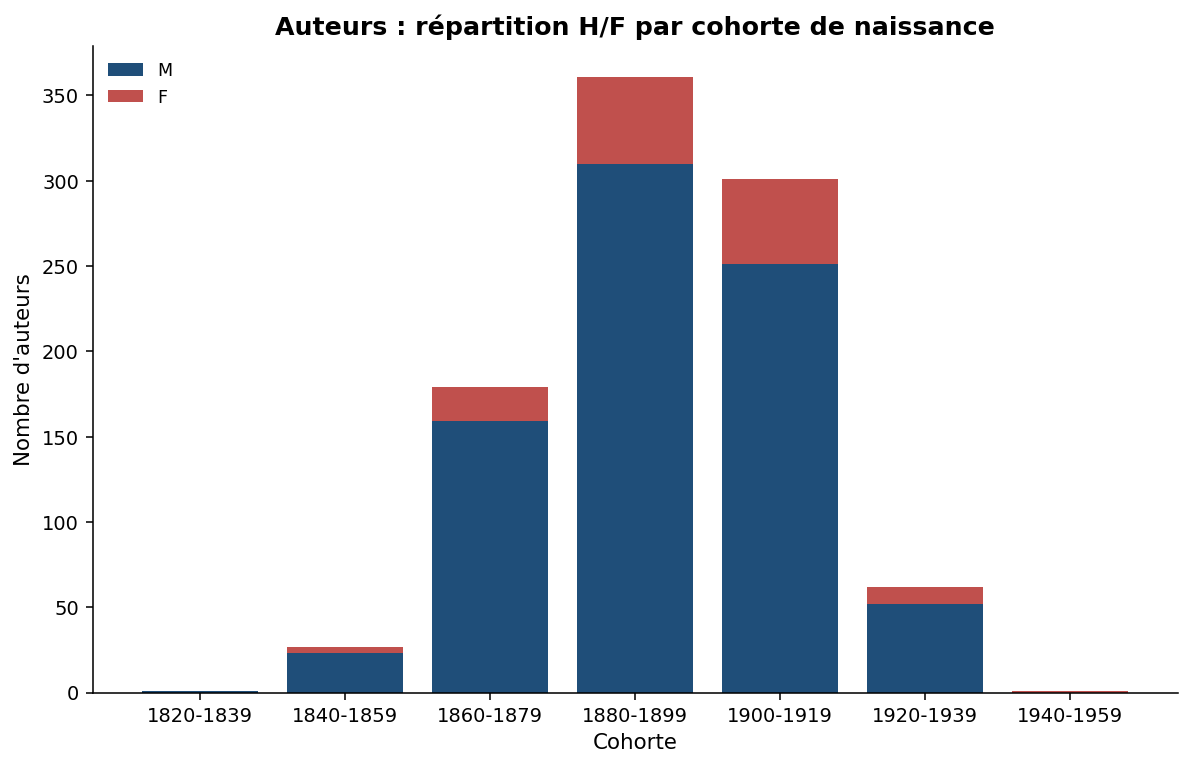
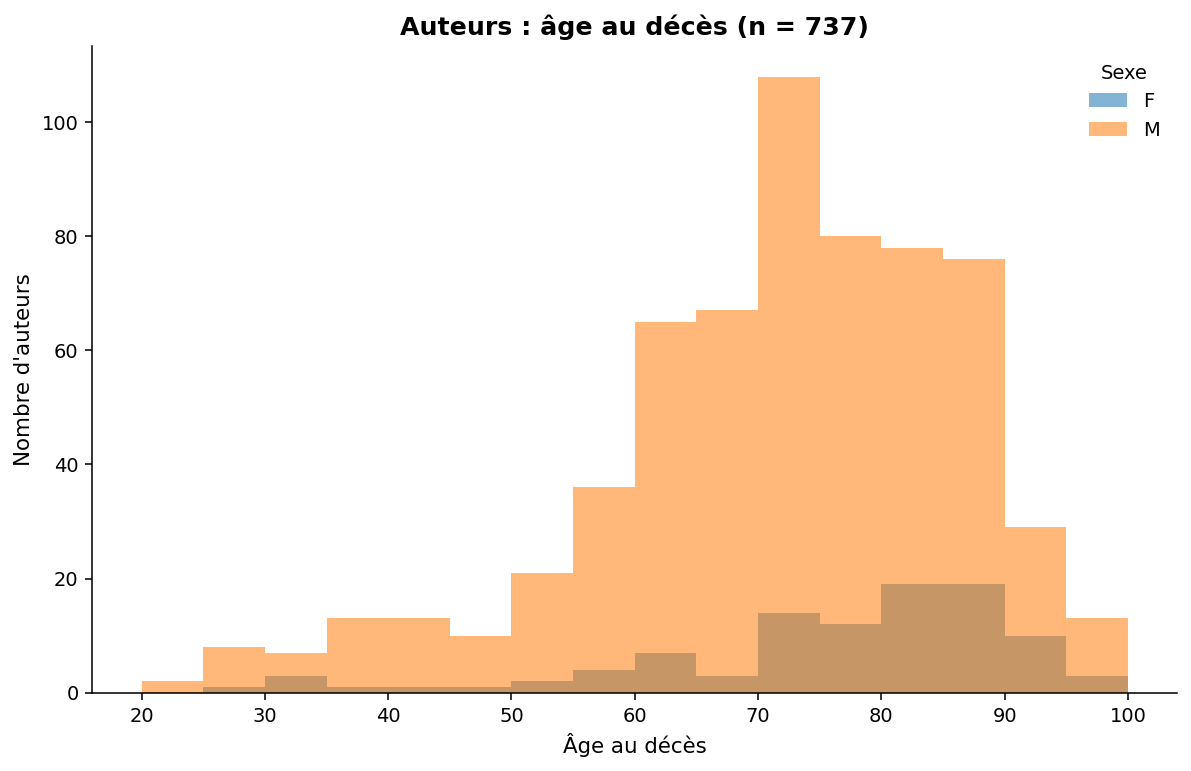
De même sur les œuvres : l’outil produit quelques représentations qui n’avaient pas été présentées telles quelles, mais rien de bouleversant.
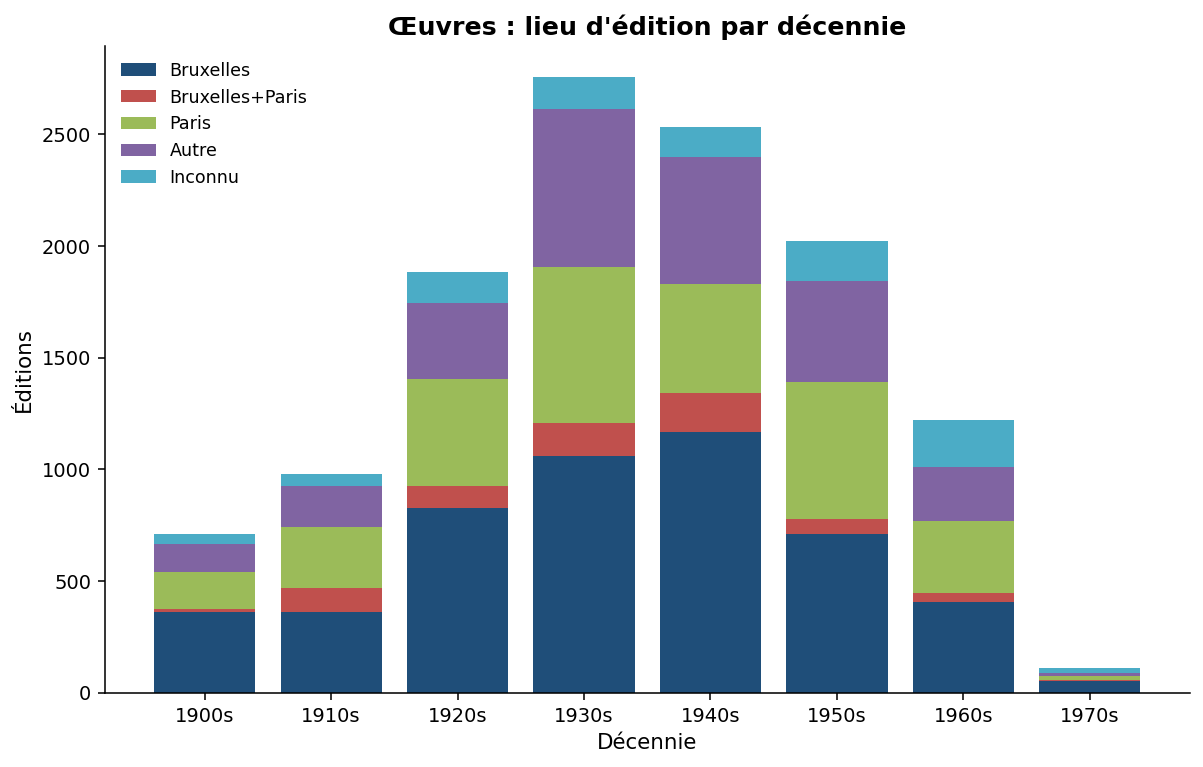
Le nombre d’œuvres par genre et par décennie n’avait pas été calculé de la sorte (figure 4).
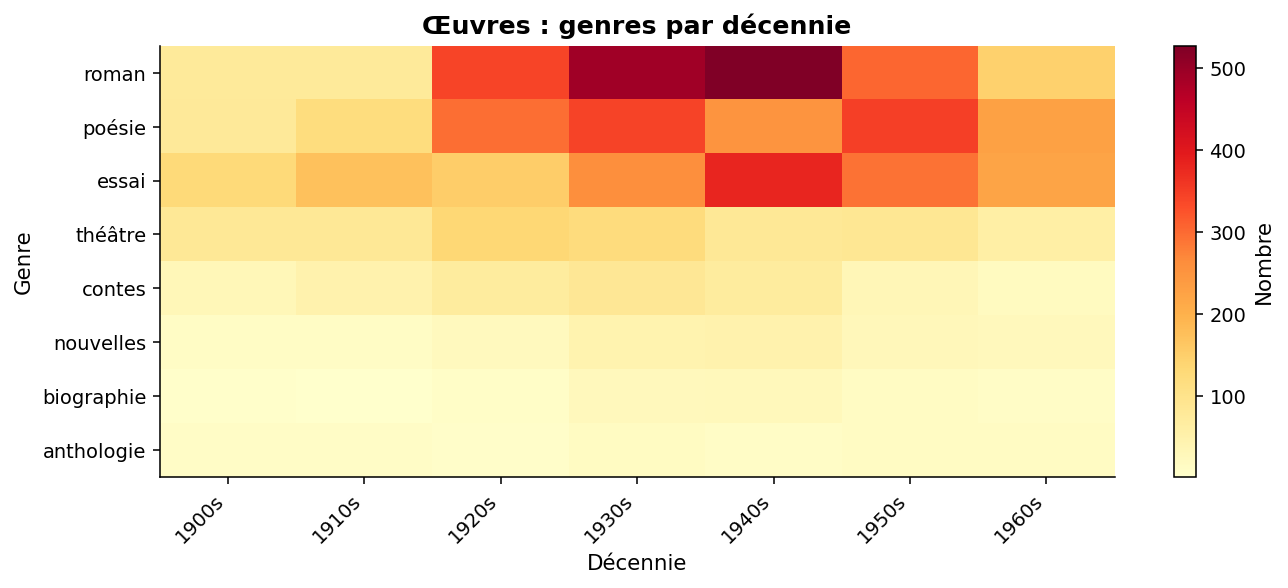
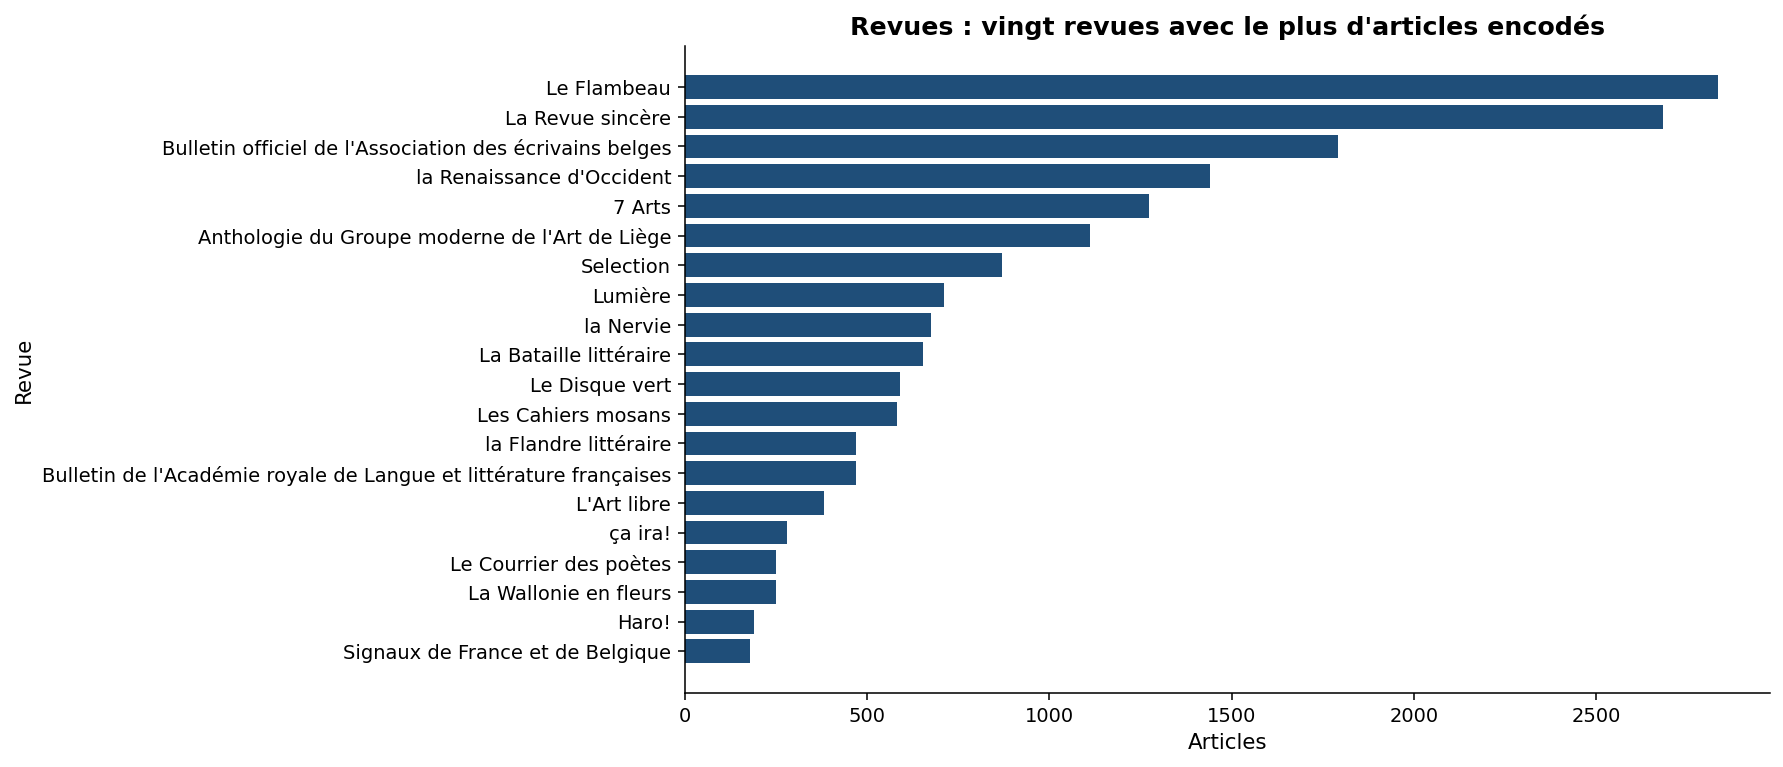
Je suis donc resté sur ma faim lors de ce tour de chauffe. Les données ne « parlent » pas d’elles-mêmes, et le modèle de langage est peu disert à leur sujet. Au mieux, ces premiers croisements de données permettent de faire un bilan du contenu de la base CIEL, comme pour les revues encodées (figure 5).
Les choses sont devenues beaucoup plus intéressantes à partir du moment où j’ai donné au chatbot plus de contexte : je lui ai demandé de tenir compte des résultats de ma thèse, publiés notamment dans deux articles de synthèse, dans Histoire et Mesure[6] et Mémoires du livre[7] et de me proposer différentes méthodes statistiques pour aller plus loin. L’analyse factorielle et l’analyse de réseaux m’avait permis de mettre en avant la catégorie des animateurs de la vie littéraire, qui reposait sur un fort capital relationnel. L’effet de ce capital sur la reconnaissance institutionnelle (je parlais de consécration, mais le terme est trop chargé pour que je continue à l’employer dans le contexte de l’examen d’une carrière durant le vivant de l’auteur[8]) avait été suggéré, mais pas montré de manière robuste. Deux options auraient pu être creusées : l’élaboration de trajectoires prototypiques à partir du corpus des écrivains et la validation du paramètre « capital relationnel » comme surdéterminant pour la reconnaissance institutionnelle au sein du sous-champ littéraire belge francophone. J’avais repéré les outils nécessaires pour envisager ces approches : l’analyse de séquences et la régression logistique, que Zalc et Lemercier présentent dans leur ouvrage. Néanmoins, la maîtrise de ces outils demandait un investissement que je n’avais jamais produit ; leur accès en est néanmoins facilité grâce à ce qu’on nomme l’IA agentique, qui aide à piloter les logiciels responsables de ces analyses et à comprendre les multiples paramètres à mobiliser. Je souhaiterais donc développer ces deux grandes pistes dans les pages qui suivent. Pour ce faire, après cette mise en contexte personnelle, je renoue avec un style explicatif plus neutre, propre à mes travaux antérieurs en sociologie de la littérature.
Notes
- Avec Claire Zalc, elle fera un manuel de cet enseignement, qui restera longtemps un de mes livres de chevet : Méthodes quantitatives pour l’historien, Paris, La Découverte, 2008, coll. « Repères ». ↩
- Sur l’histoire et la critique de l’IA, voir les travaux d’Anne Alombert, en particulier De la bêtise artificielle, Paris, Allia, 2025 et l’introduction à l’ouvrage collectif dirigé par Anne Alombert, Alban Leveau-Vallier, Baptiste Loreaux, Penser l’intelligence artificielle – Enjeux philosophiques, politiques et culturels de l’automatisation numérique, Dijon, Les Presses du Réel, 2026. Pour une explication accessible des enjeux liés au progrès de la décennie 2010-2020, voir Melanie Mitchell, Intelligence artificielle : triomphes et déceptions, Malakoff, Dunod, 2021. Sur les hauts et les bas des différents paradigmes au sein du champ de l’IA, voir Dominique Cardon, Jean-Philippe Cointet et Antoine Mazières, « La revanche des neurones. L’invention des machines inductives et la controverse de l’intelligence artificielle », in Réseaux, vol. 211 (16 novembre 2018), no 5, p. 173-220. ↩
- Voir à ce sujet l’essai vivifiant d’Emily M. Bender et Alex Hanna, The IA Con. How to Fight Big Tech’s Hype and Creat the Future We Want, New York, Harper Collins, 2025, qui rappelle qu’il ne faut pas se laisser berner par les discours promotionnels creux reposant sur des promesses irréalistes. Bender avait déjà cosigné un article comparant les chatbots à des « perroquets stochastiques », fortement dépendant des données d’entraînement : Emily M. Bender, Timnit Gebru, Angelina McMillan-Major, Shmargaret Shmitchell, « On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? », Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency, 2021, doi:10.1145/3442188.3445922. ↩
- Voir https://bjorn-olav.net/571 et https://bjorn-olav.net/566. ↩
- Voir https://bjorn-olav.net/563. ↩
- Björn-Olav Dozo, « Sociabilités et réseaux littéraires au sein du sous-champ belge francophone de l’entre-deux-guerres », in Histoire et Mesure, XXIV (2009), no 1. ↩
- Björn-Olav Dozo, « La production littéraire des Belges francophones durant l’entre-deux-guerres. Examen d’un premier inventaire », in Mémoires du Livre, vol. 1 (2010), no 2. ↩
- Sur la question de la consécration en Belgique francophone, voir Björn-Olav Dozo et François Provenzano, « Comment les écrivains sont consacrés en Belgique », COnTEXTES, 7 | 2010. URL : http://journals.openedition.org/contextes/4637 ; DOI : https://doi.org/10.4000/contextes.4637. Dans cet article, nous isolions deux scènes consécratoires, l’ARLLF et les groupes surréalistes belges, qui répondaient à des logiques institutionnelles différentes. Pour éviter la contradiction avec ces scènes consécratoires et mieux rendre raison de ce que j’observe réellement lors de l’examen de la régression logistique, j’ai choisi de nommer cette variable la reconnaissance institutionnelle. ↩
- Andrew Abbott, « Sequence Analysis: New Methods for Old Ideas », Annual Review of Sociology, vol. 21, 1995, p. 93-113. ↩
- Laurent Lesnard and Thibaut de Saint Pol, « Introduction aux méthodes d’appariement optimal (Optimal Matching Analysis) », Bulletin de méthodologie sociologique, 90 | 2006, p. 5-25, http://journals.openedition.org/bms/638 et Laurent Lesnard, « Setting Cost in Optimal Matching to Uncover Contemporaneous Socio-Temporal Patterns », Sociological Methods & Research, vol. 38, n° 3, 2010, p. 389-419. Une synthèse française peut aussi être mise en avant : Nicolas Robette, Explorer et décrire les parcours de vie : les typologies de trajectoires, Paris, Ceped, coll. « Les Clefs pour », 2011. ↩


 À propos